

Платформа данных для AI-агентов с RAG
Что происходит, когда более 30 команд независимо строят ingestion-пайплайны, выбирают chunking, хранят собственные векторные индексы и продолжают отвечать по устаревшим редакциям документов? Диана Аимбетова разбирает архитектуру единой платформы данных для AI-агентов — от исходного файла до ответа RAG-системы.
Целевая архитектура разделена на пять слоёв: MinIO как единый источник сырых файлов, PostgreSQL-каталог метаданных, Airflow + Celery для оркестрации, пайплайны обработки документов и единый Retrieval API на FastAPI.
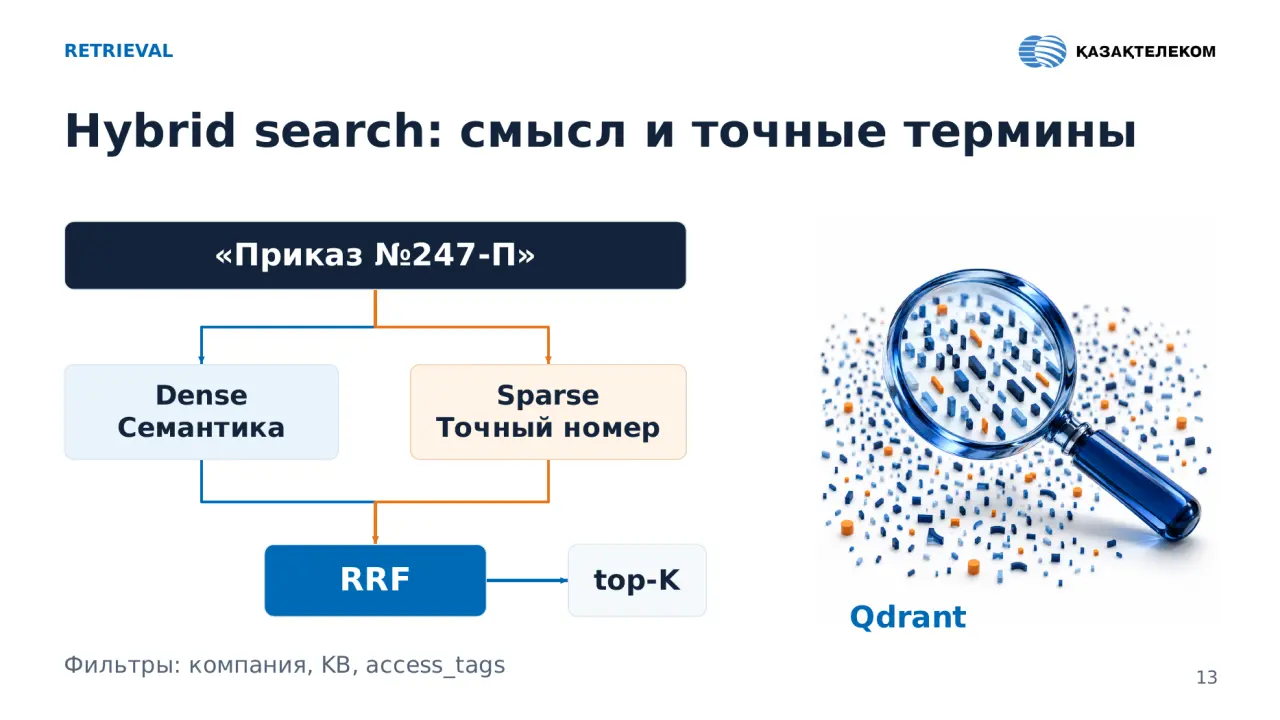
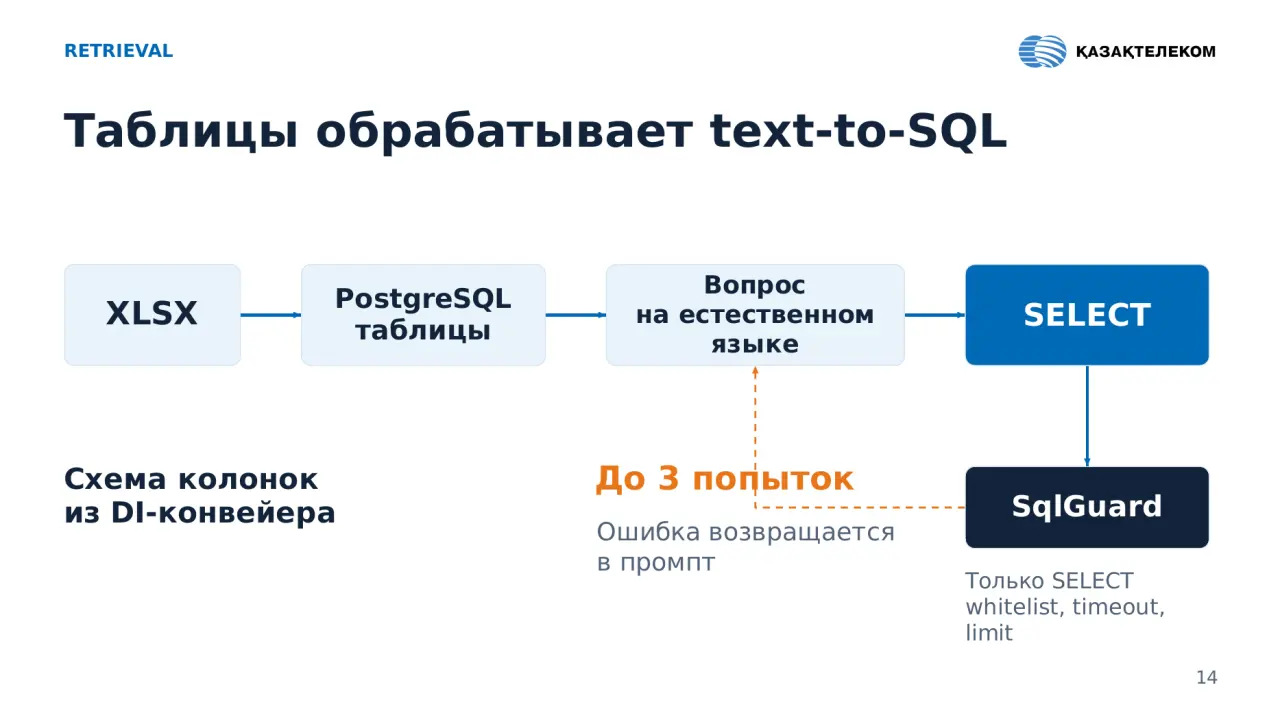
В докладе: — почему по ходу проекта от Dagster перешли на Airflow + Celery — как маршрутизировать PDF, DOCX, таблицы, сканы и смешанные документы — почему один универсальный chunker — антипаттерн и как устроен registry стратегий — как совместить dense и sparse retrieval в Qdrant с точным text-to-SQL для таблиц — как обновление документа запускает каскадную реиндексацию и сохраняет полный lineage — как обеспечить tenant isolation, аудит запросов и масштабирование retrieval для десятков агентов
Видео
Презентация
 1 / 23
Текст презентации
Слайд 1: PYTHON DEV MEETING
PYTHON DEV MEETING RAG-платформа данных для 30+ AI-агентов Ingestion, Catalog, Processing, Retrieval Всё на Python Диана Аимбетова Tech Lead, Казахтелеком
Слайд 2: ЗНАКОМСТВО
ЗНАКОМСТВО Диана Аимбетова Tech Lead Казахтелеком Внедряем ИИ в портфеле Самрук-Казына “Мы создаём AI-агентов и сами столкнулись с проблемой данных HR Финансы Право HSE PR
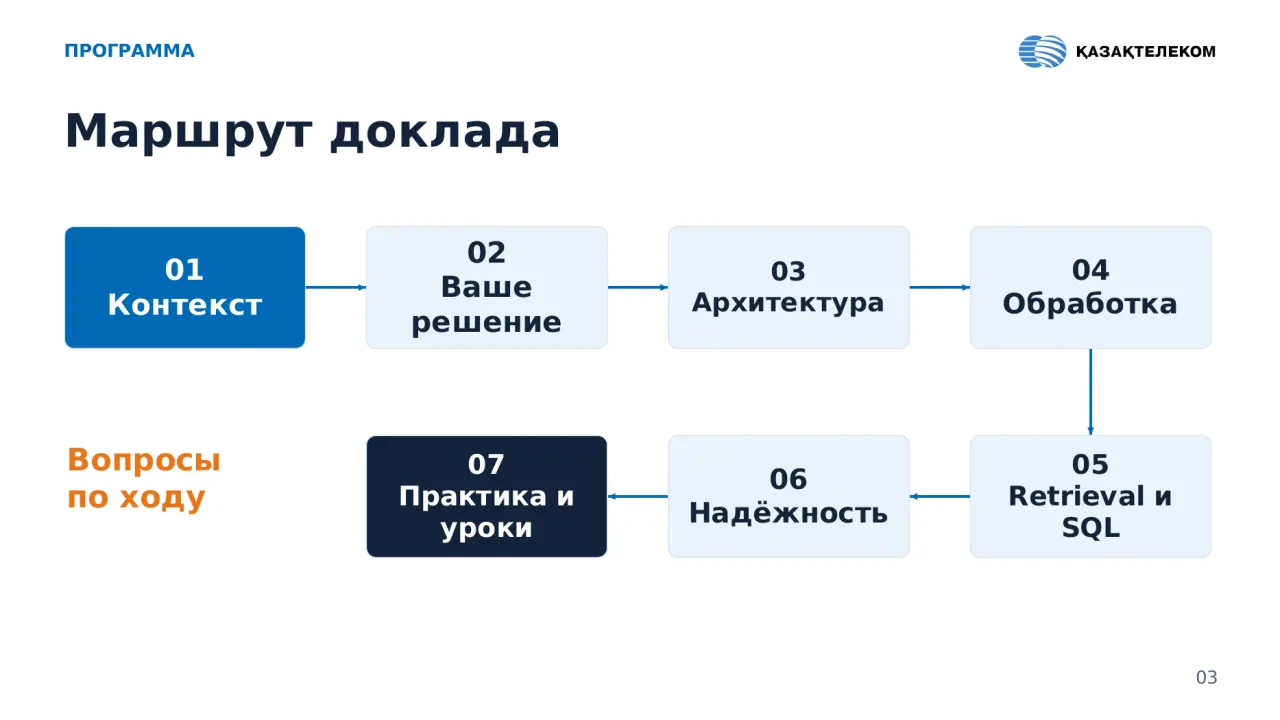
Слайд 3: ПРОГРАММА
ПРОГРАММА Маршрут доклада Контекст Ваше решение Архитектура Обработка Retrieval и SQL Надёжность Практика и уроки Вопросы по ходу
Слайд 4: КОНТЕКСТ
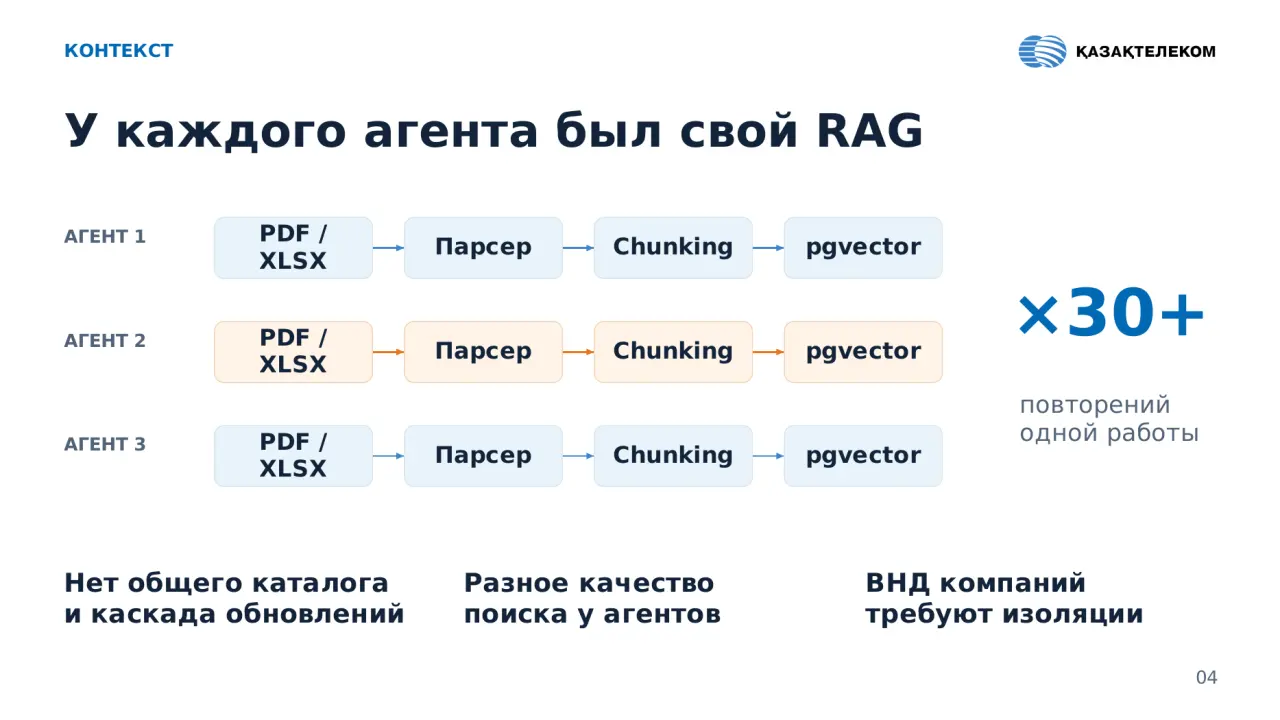
КОНТЕКСТ У каждого агента был свой RAG АГЕНТ 1 PDF / XLSX Парсер Chunking pgvector АГЕНТ 2 PDF / XLSX Парсер Chunking pgvector АГЕНТ 3 PDF / XLSX Парсер Chunking pgvector повторений одной работы Нет общего каталога и каскада обновлений Разное качество поиска у агентов ВНД компаний требуют изоляции
Слайд 5: ОБСУЖДЕНИЕ
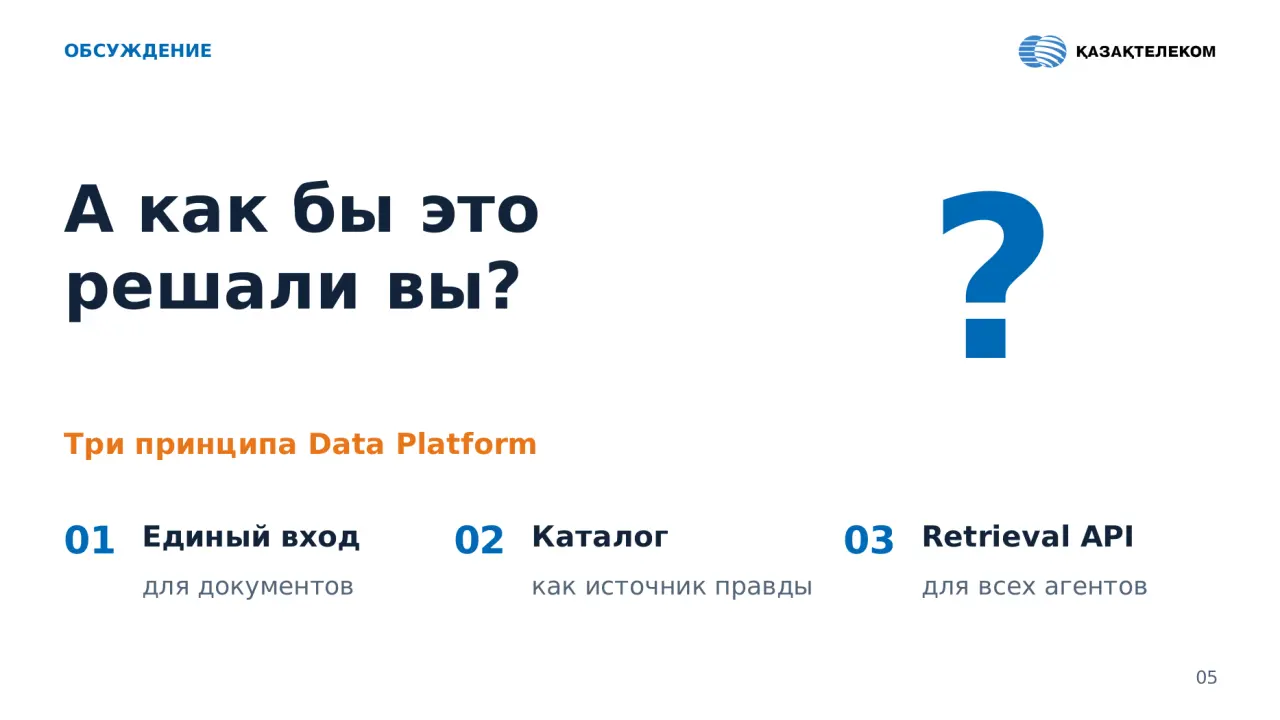
ОБСУЖДЕНИЕ А как бы это решали вы? Три принципа Data Platform 01 Единый вход для документов 02 Каталог как источник правды 03 Retrieval API для всех агентов
Слайд 6: АРХИТЕКТУРА
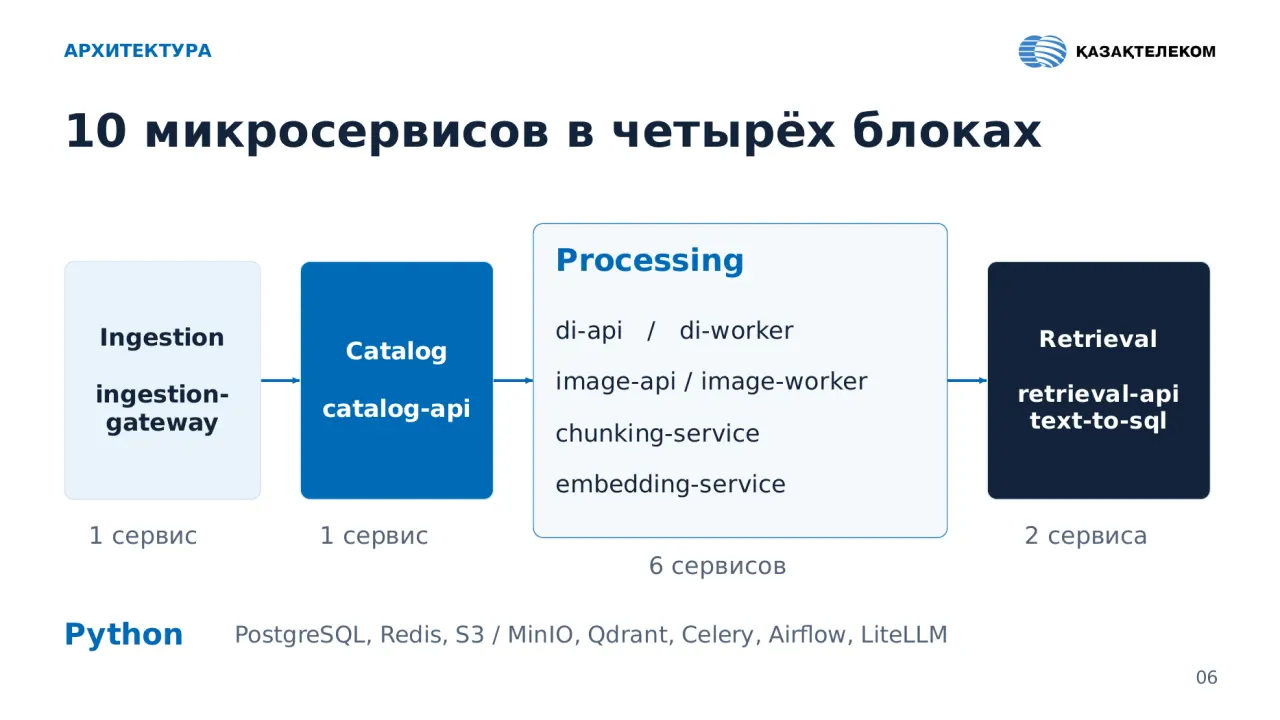
АРХИТЕКТУРА 10 микросервисов в четырёх блоках Ingestion ingestion- gateway Catalog catalog-api Processing di-api / di-worker image-api / image-worker chunking-service embedding-service Retrieval retrieval-api text-to-sql 1 сервис 1 сервис 6 сервисов 2 сервиса Python PostgreSQL, Redis, S3 / MinIO, Qdrant, Celery, Airflow, LiteLLM
Слайд 7: АРХИТЕКТУРА
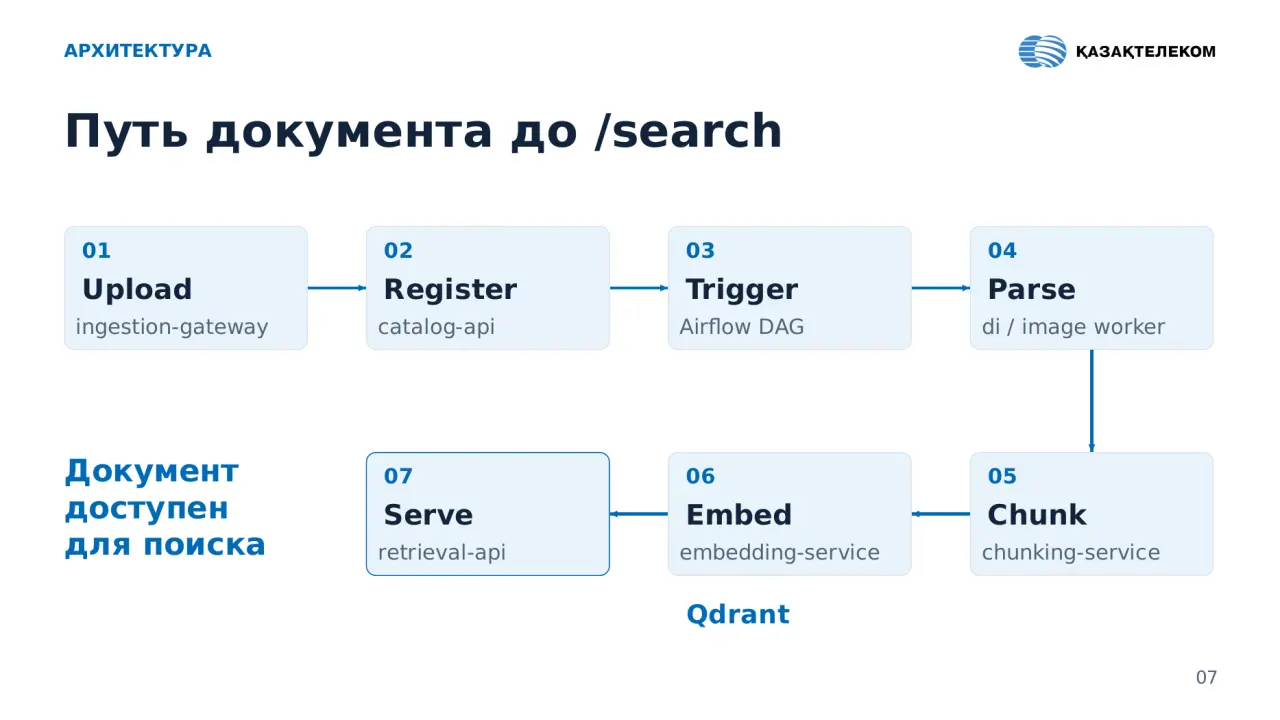
АРХИТЕКТУРА Путь документа до /search Upload ingestion-gateway Register catalog-api Trigger Airflow DAG Parse di / image worker Chunk chunking-service Embed embedding-service Serve retrieval-api Qdrant Документ доступен для поиска
Слайд 8: CATALOG
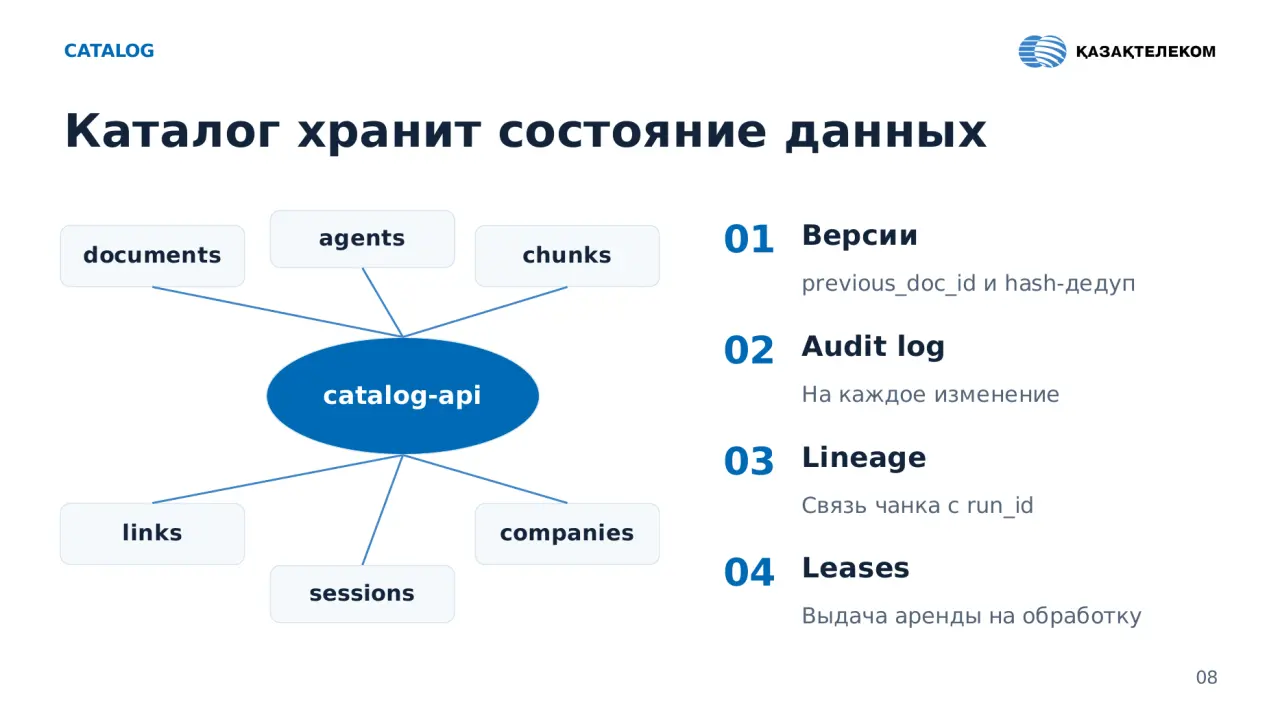
CATALOG Каталог хранит состояние данных catalog-api documents chunks links companies agents sessions 01 Версии previous_doc_id и hash-дедуп 02 Audit log На каждое изменение 03 Lineage Связь чанка с run_id 04 Leases Выдача аренды на обработку
Слайд 9: PROCESSING
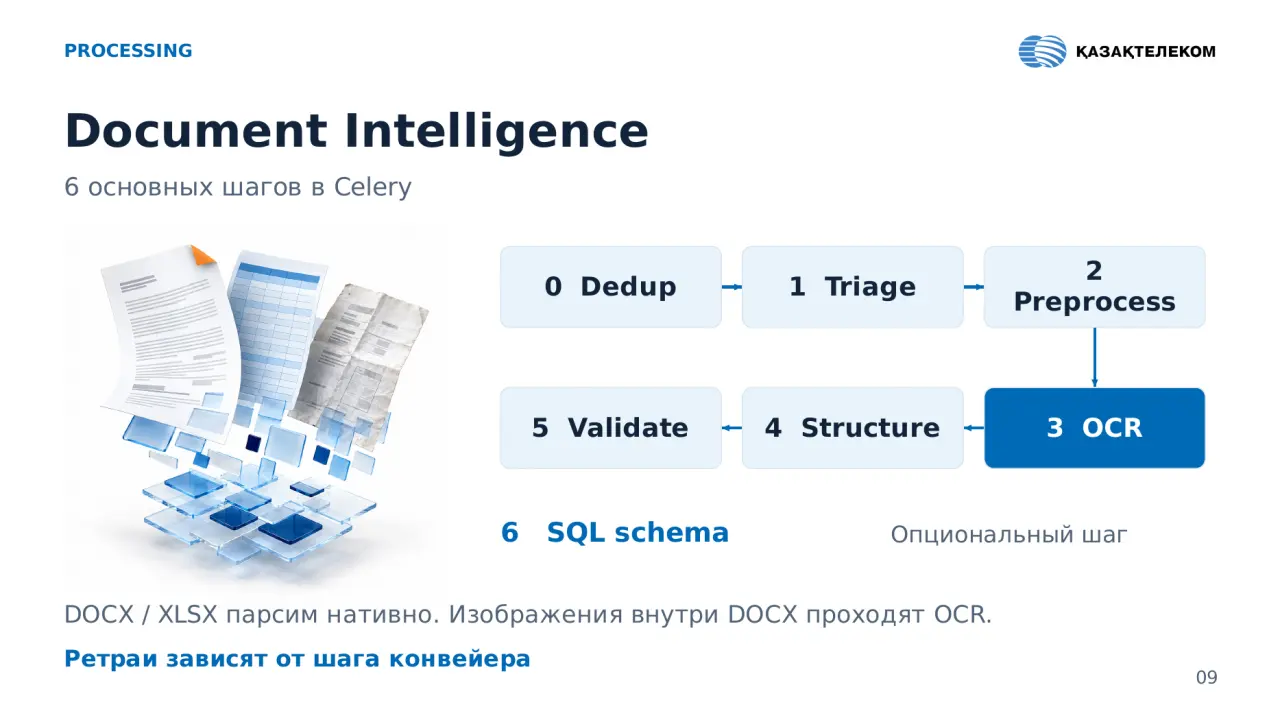
PROCESSING Document Intelligence 6 основных шагов в Celery 0 Dedup 1 Triage Preprocess 5 Validate 4 Structure 3 OCR 6 SQL schema Опциональный шаг DOCX / XLSX парсим нативно. Изображения внутри DOCX проходят OCR. Ретраи зависят от шага конвейера
Слайд 10: PROCESSING
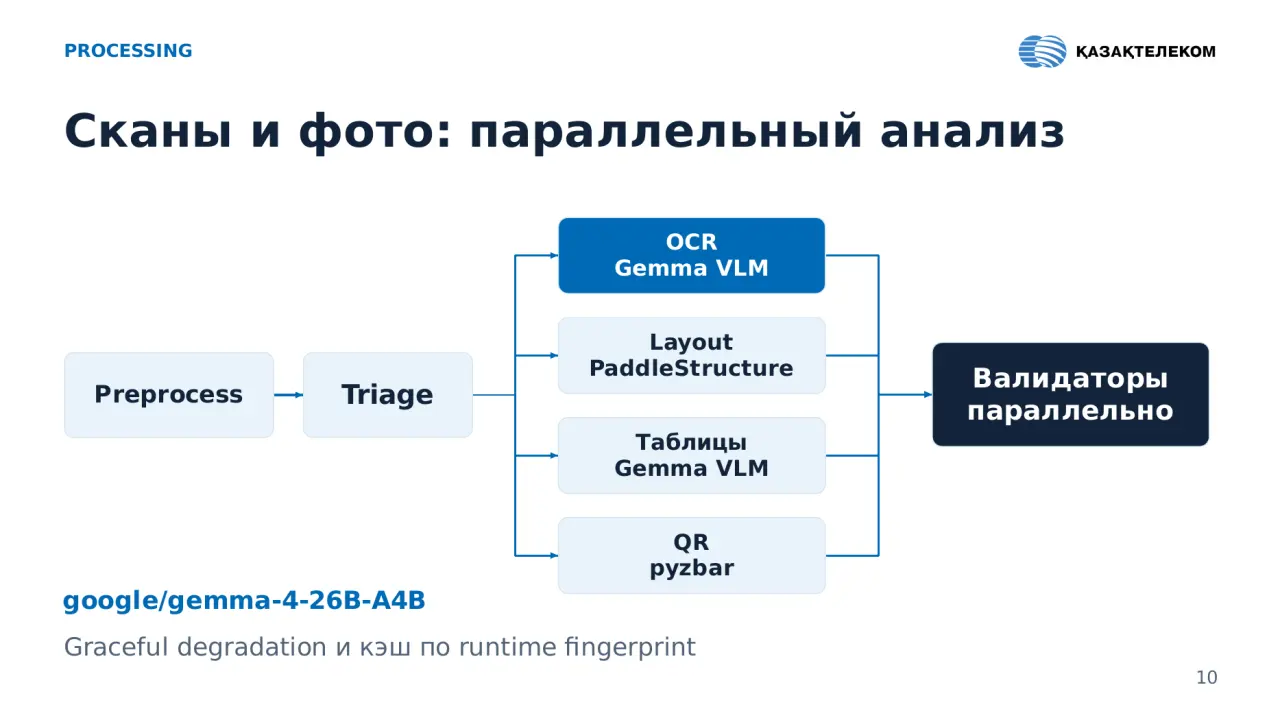
PROCESSING Сканы и фото: параллельный анализ Preprocess Triage OCR Gemma VLM Layout PaddleStructure Таблицы Gemma VLM pyzbar Валидаторы параллельно google/gemma-4-26B-A4B Graceful degradation и кэш по runtime fingerprint
Слайд 11: CHUNKING
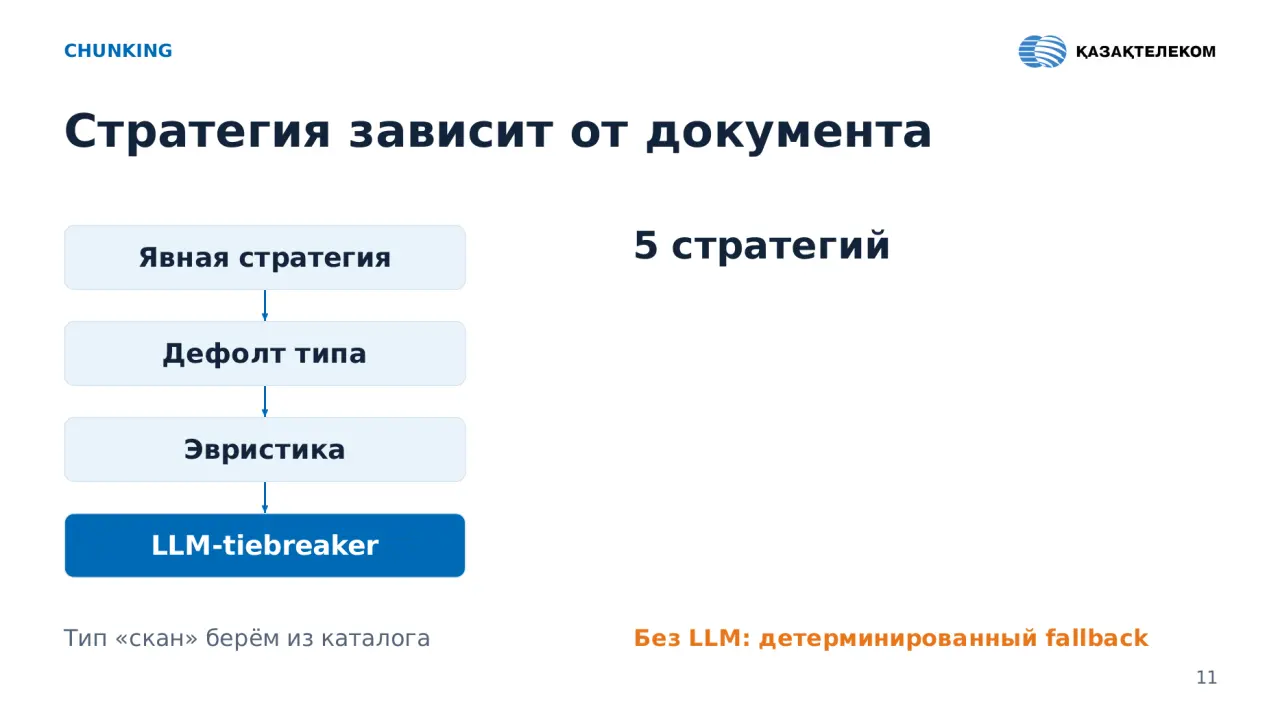
CHUNKING Стратегия зависит от документа Явная стратегия Дефолт типа Эвристика LLM-tiebreaker 5 стратегий Тип «скан» берём из каталога Без LLM: детерминированный fallback
Слайд 12: EMBEDDINGS
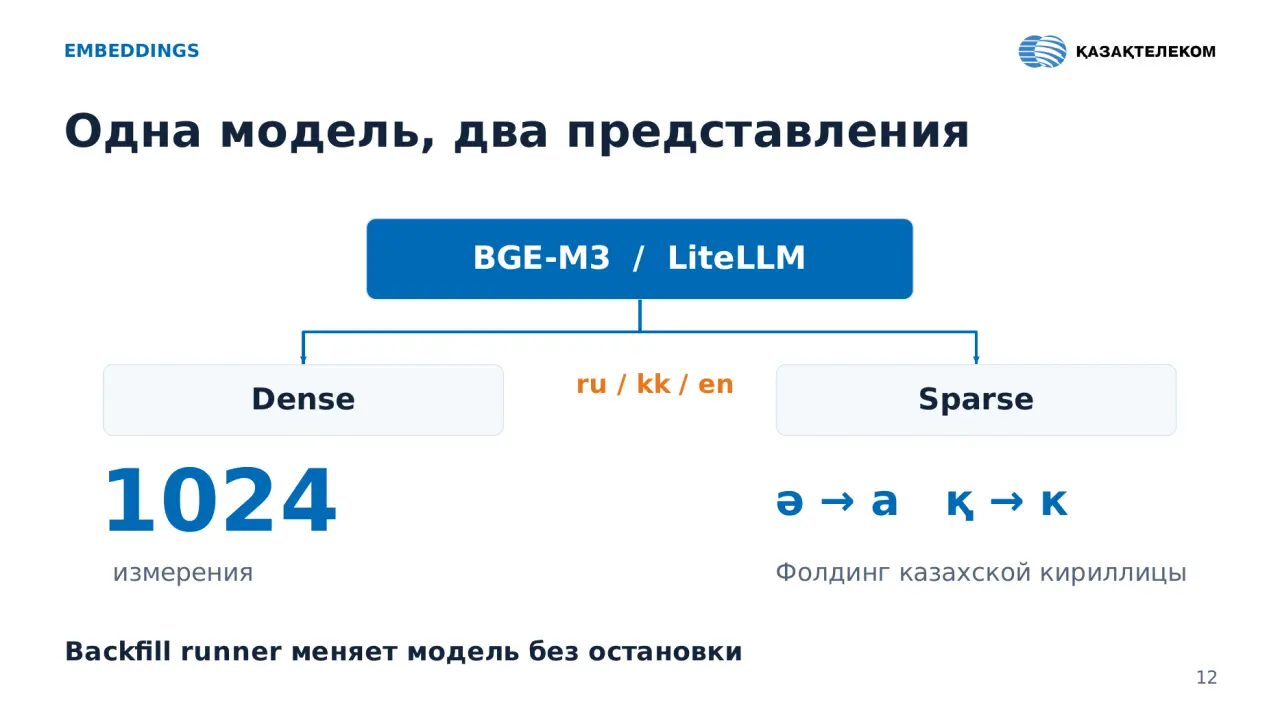
EMBEDDINGS Одна модель, два представления BGE-M3 / LiteLLM Dense Sparse измерения Фолдинг казахской кириллицы Backfill runner меняет модель без остановки
Слайд 13: RETRIEVAL
RETRIEVAL Hybrid search: смысл и точные термины «Приказ №247-П» Dense Семантика Sparse Точный номер RRF top-K Qdrant Фильтры: компания, KB, access_tags
Слайд 14: RETRIEVAL
RETRIEVAL Таблицы обрабатывает text-to-SQL XLSX PostgreSQL таблицы Вопрос на естественном языке SELECT SqlGuard Схема колонок из DI-конвейера До 3 попыток Ошибка возвращается в промпт Только SELECT whitelist, timeout, limit
Слайд 15: НАДЁЖНОСТЬ
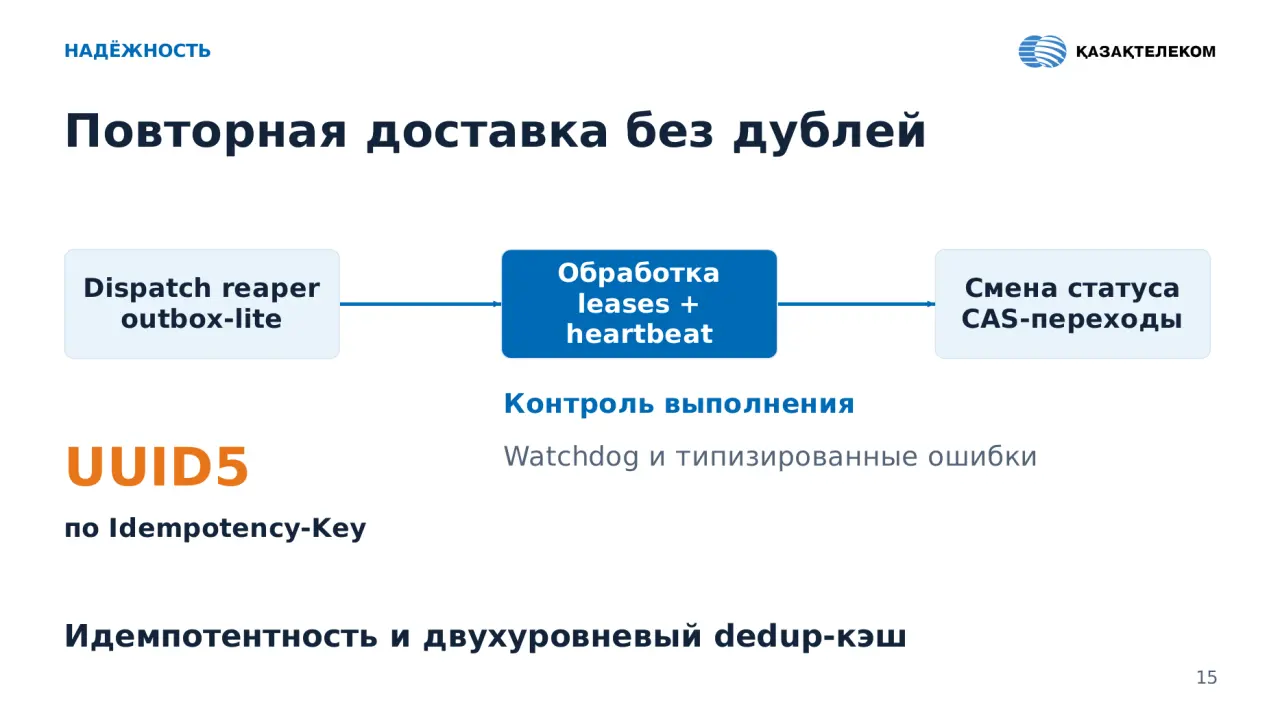
НАДЁЖНОСТЬ Повторная доставка без дублей Dispatch reaper outbox-lite Обработка leases + heartbeat Смена статуса CAS-переходы Контроль выполнения Watchdog и типизированные ошибки UUID5 по Idempotency-Key Идемпотентность и двухуровневый dedup-кэш
Слайд 16: ПРАКТИКА
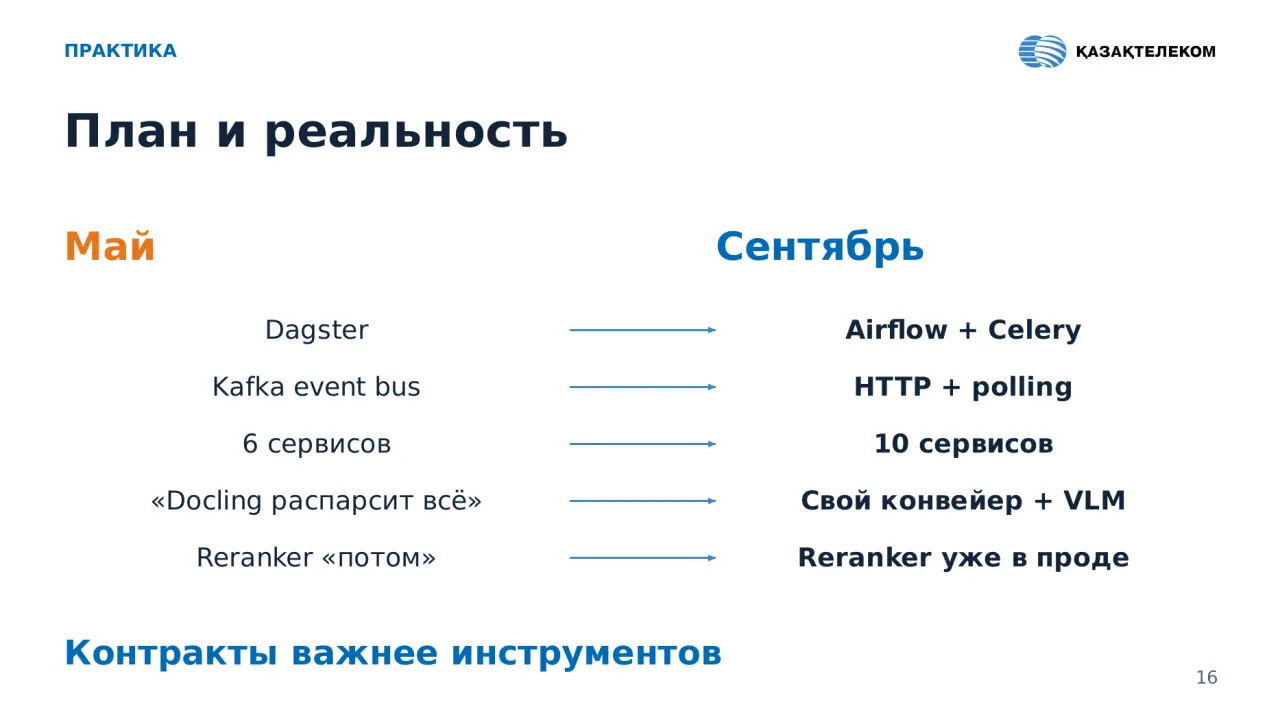
ПРАКТИКА План и реальность Май Сентябрь Dagster Airflow + Celery Kafka event bus HTTP + polling 6 сервисов 10 сервисов «Docling распарсит всё» Свой конвейер + VLM Reranker «потом» Reranker уже в проде Контракты важнее инструментов
Слайд 17: СТЕК
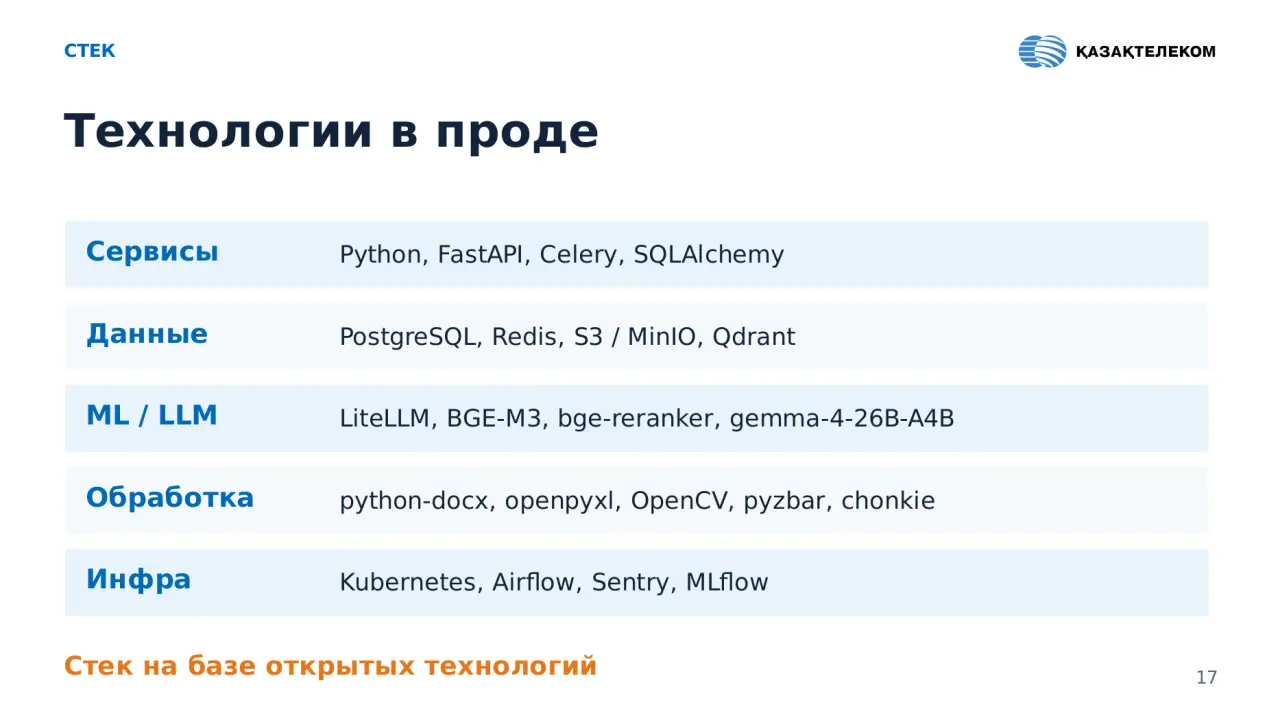
СТЕК Технологии в проде Сервисы Python, FastAPI, Celery, SQLAlchemy Данные PostgreSQL, Redis, S3 / MinIO, Qdrant ML / LLM LiteLLM, BGE-M3, bge-reranker, gemma-4-26B-A4B Обработка python-docx, openpyxl, OpenCV, pyzbar, chonkie Инфра Kubernetes, Airflow, Sentry, MLflow Стек на базе открытых технологий
Слайд 18: КАЧЕСТВО
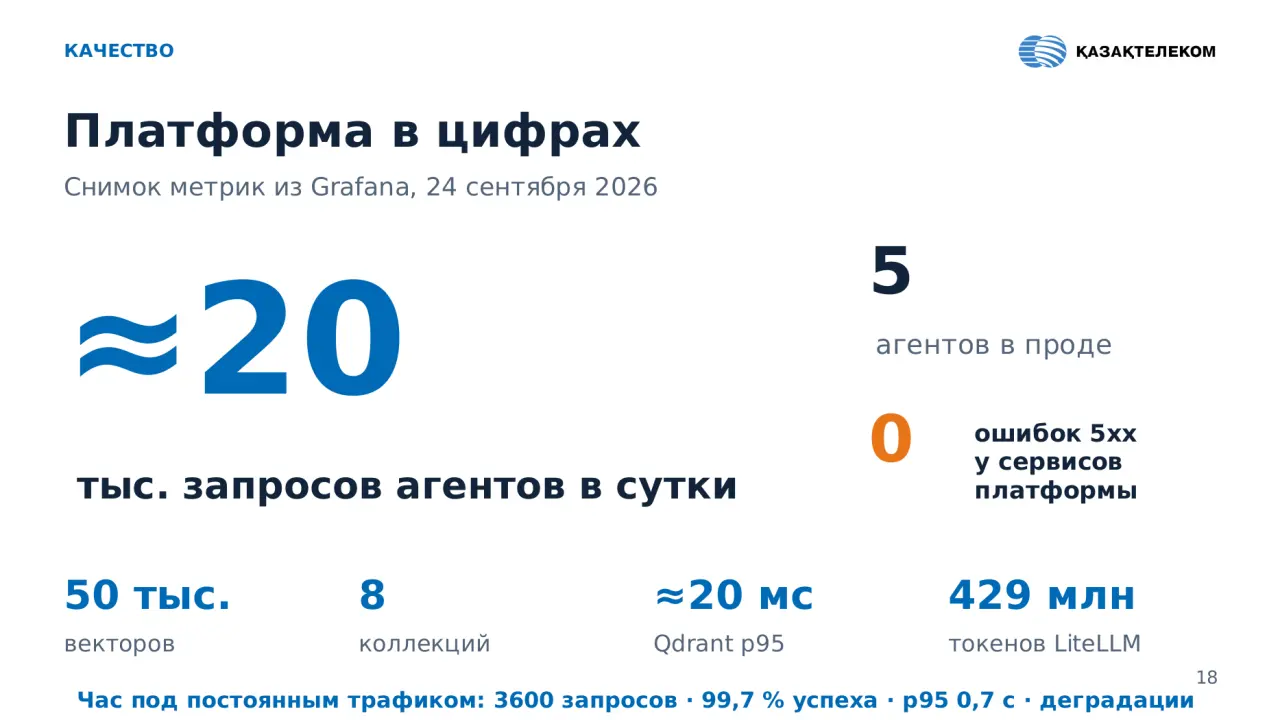
КАЧЕСТВО Платформа в цифрах Снимок метрик из Grafana, 24 сентября 2026 тыс. запросов агентов в сутки агентов в проде 0 ошибок 5xx у сервисов платформы 50 тыс. векторов коллекций Qdrant p95 429 млн токенов LiteLLM Час под постоянным трафиком: 3600 запросов · 99,7 % успеха · p95 0,7 с · деградации
Слайд 19: МЕТРИКИ
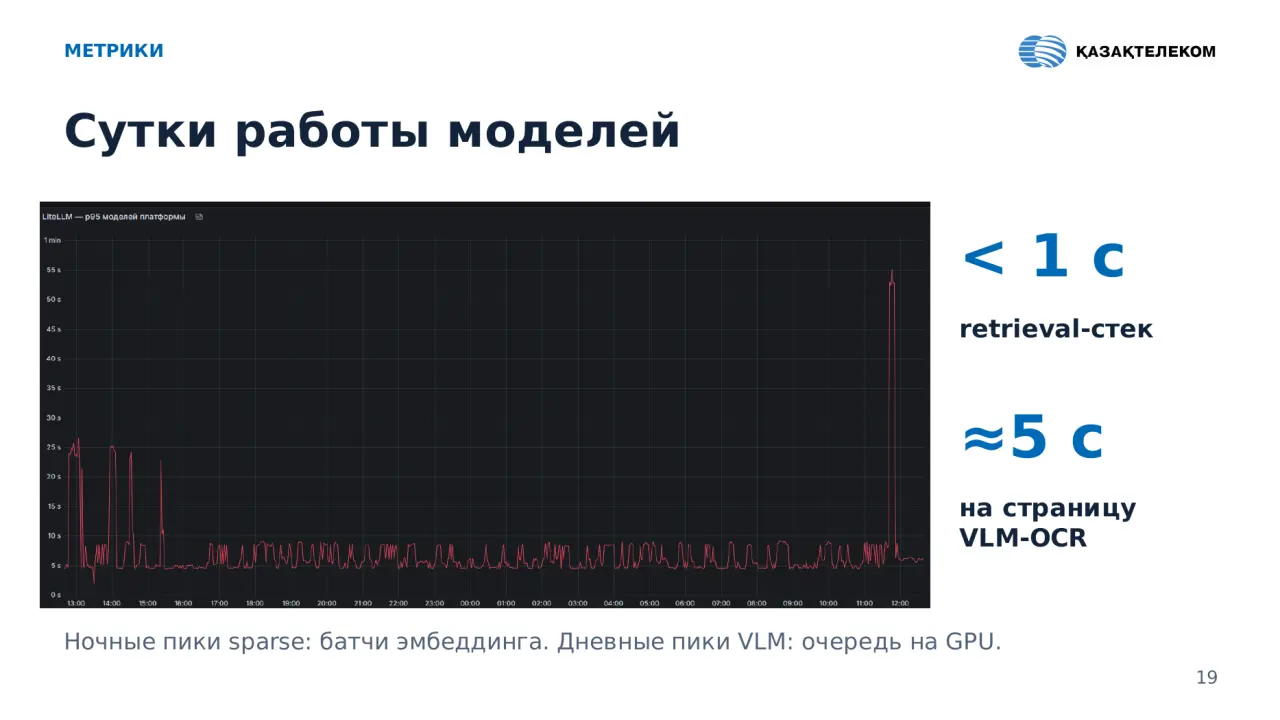
МЕТРИКИ Сутки работы моделей retrieval-стек на страницу VLM-OCR Ночные пики sparse: батчи эмбеддинга. Дневные пики VLM: очередь на GPU.
Слайд 20: МЕТРИКИ
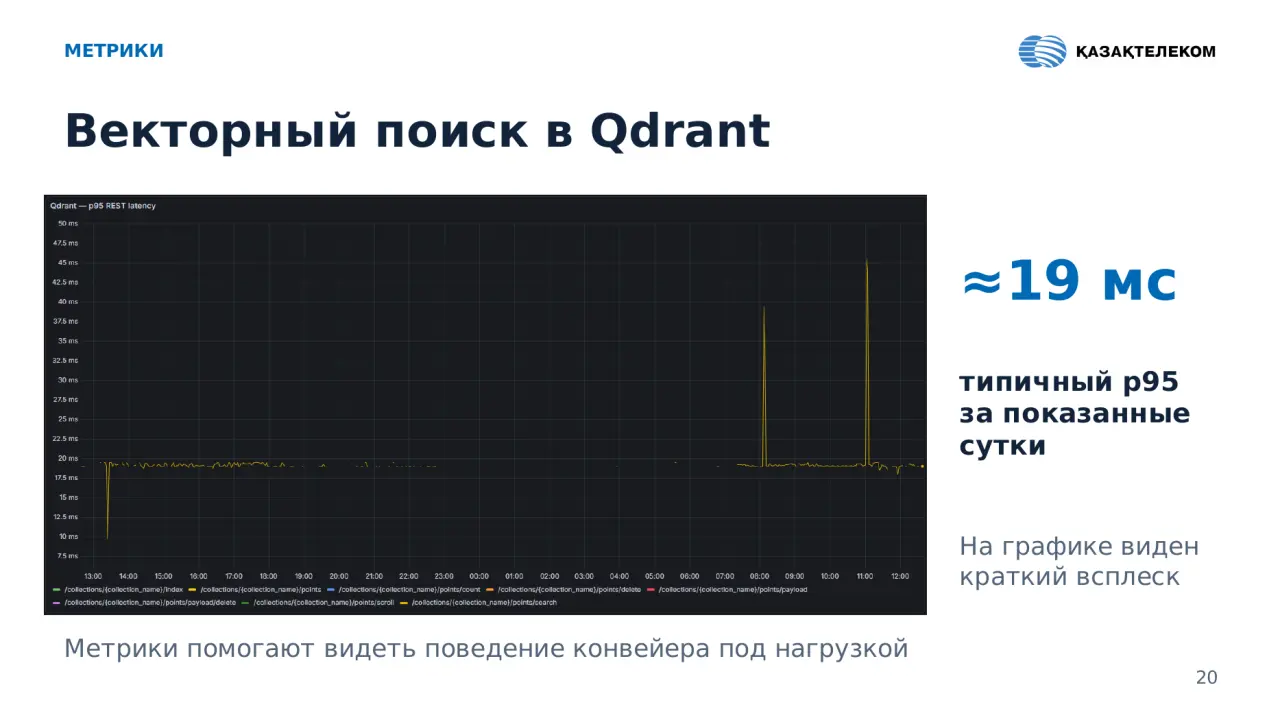
МЕТРИКИ Векторный поиск в Qdrant типичный p95 за показанные сутки На графике виден краткий всплеск Метрики помогают видеть поведение конвейера под нагрузкой
Слайд 21: СРАВНЕНИЕ
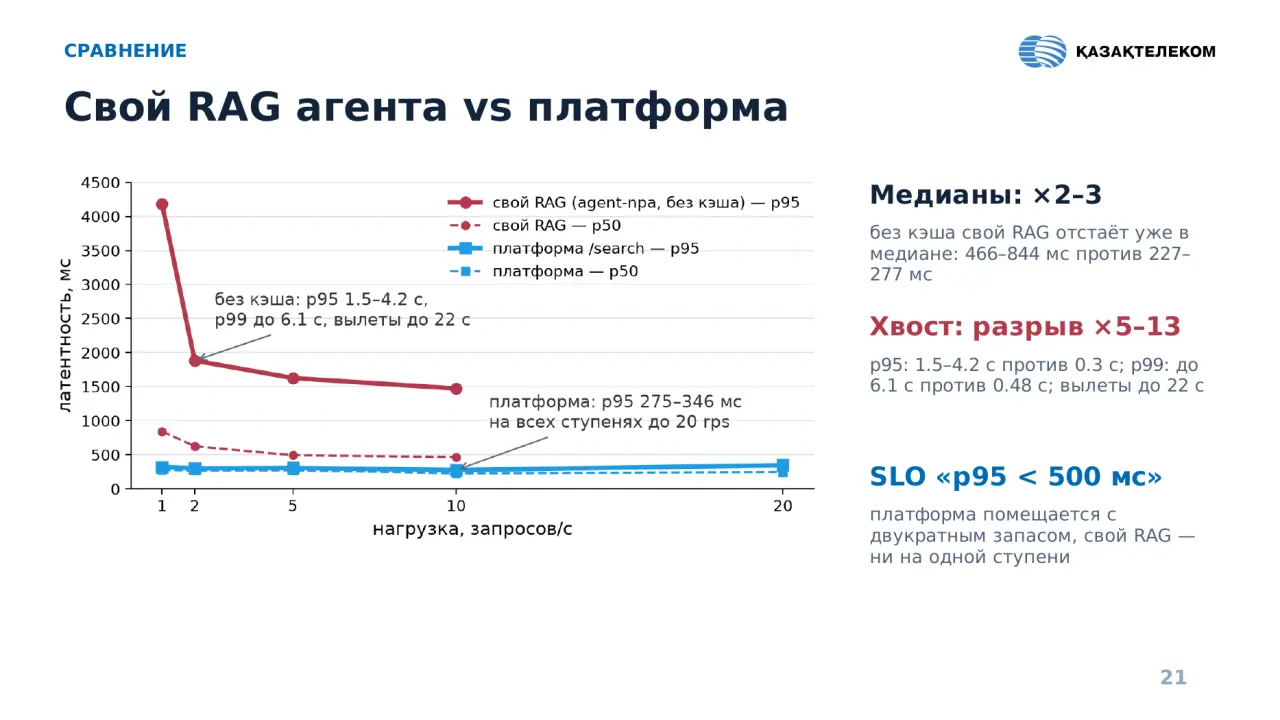
СРАВНЕНИЕ Свой RAG агента vs платформа Медианы: ×2–3 без кэша свой RAG отстаёт уже в медиане: 466–844 мс против 227– Хвост: разрыв ×5–13 p95: 1.5–4.2 с против 0.3 с; p99: до 6.1 с против 0.48 с; вылеты до 22 с SLO «p95 < 500 мс» платформа помещается с двукратным запасом, свой RAG — ни на одной ступени
Слайд 22: УРОКИ
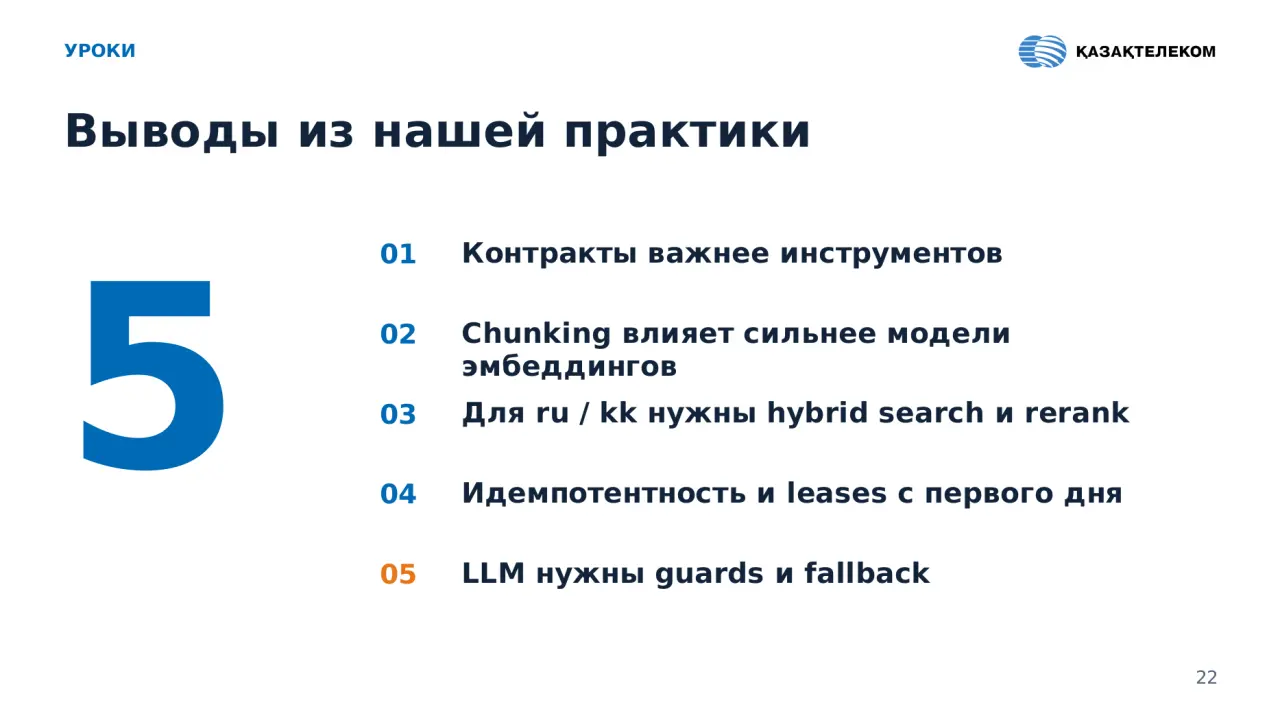
УРОКИ Выводы из нашей практики 01 Контракты важнее инструментов 02 Chunking влияет сильнее модели эмбеддингов 03 Для ru / kk нужны hybrid search и rerank 04 Идемпотентность и leases с первого дня 05 LLM нужны guards и fallback
Слайд 23: ОБСУЖДЕНИЕ
ОБСУЖДЕНИЕ Вопросы? Хотите решать такие задачи? Мы в поисках AI-инженеров Диана Аимбетова Telegram: @AIM_DI
Другие доклады митапа
 Когда ИИ уверенно ошибается Александр Канцеляристов
 Agentic SDLC: от постановки задачи до продакшена с AI-агентами Азамат Галимжанов
 Обновление Python в 30+ ML-сервисах: uv, Ruff и ty Денис Крумко
 Мой код говорит сам за себя: как заставить его говорить и не запинаться Болат Тишкамбеков