

Когда ИИ уверенно ошибается
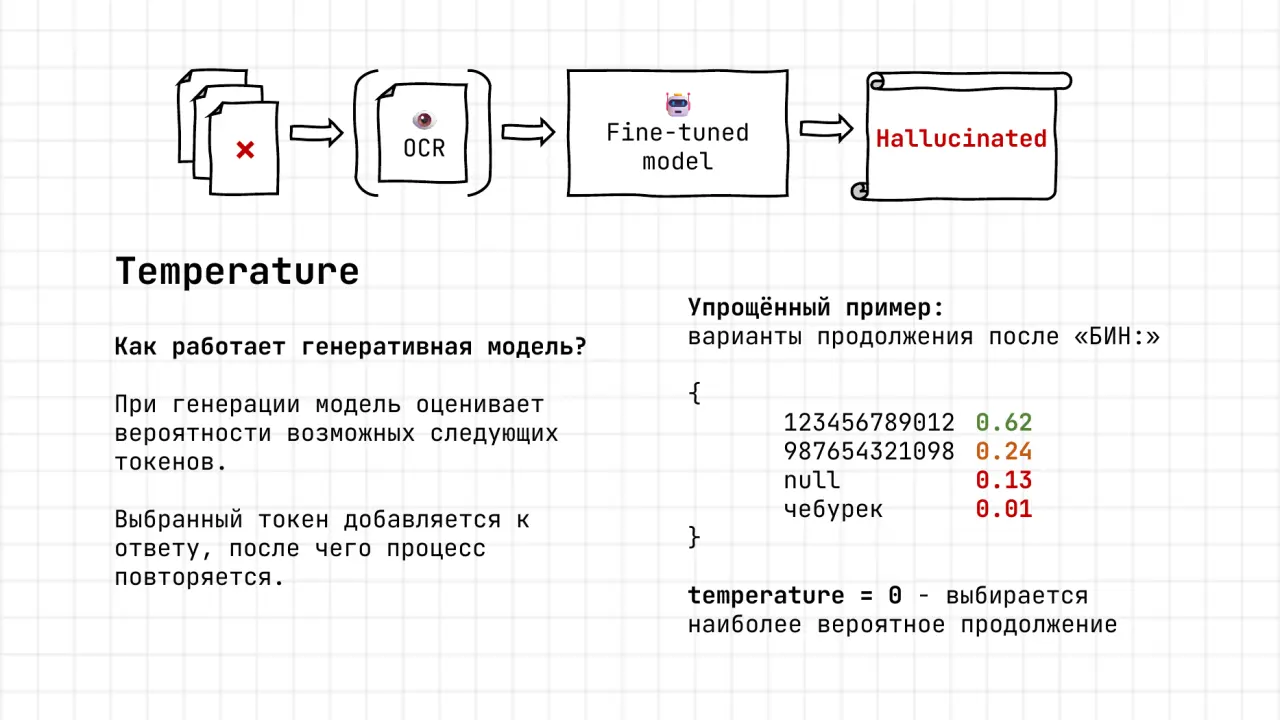
Генеративная модель не «знает правильный ответ и иногда ошибается» — она строит наиболее вероятное продолжение. Когда входной сигнал слабый, пустой или находится вне обучающего распределения, правдоподобный ответ может оказаться полностью выдуманным.
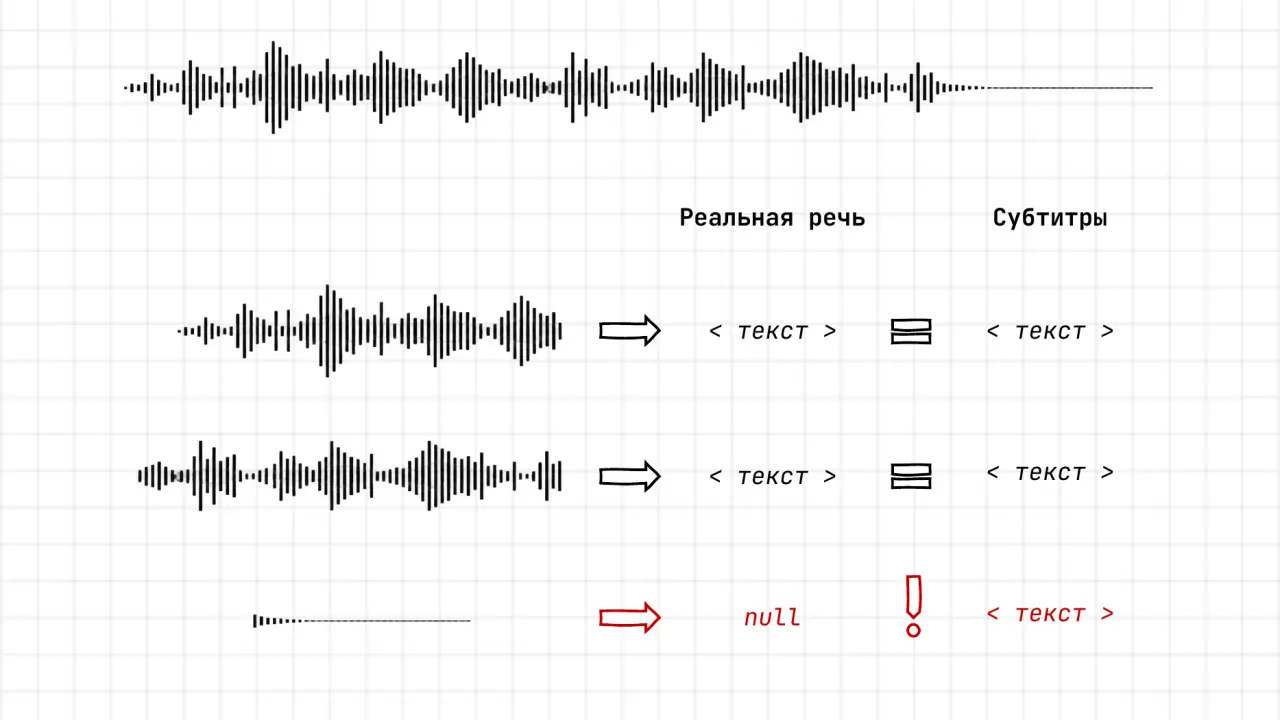
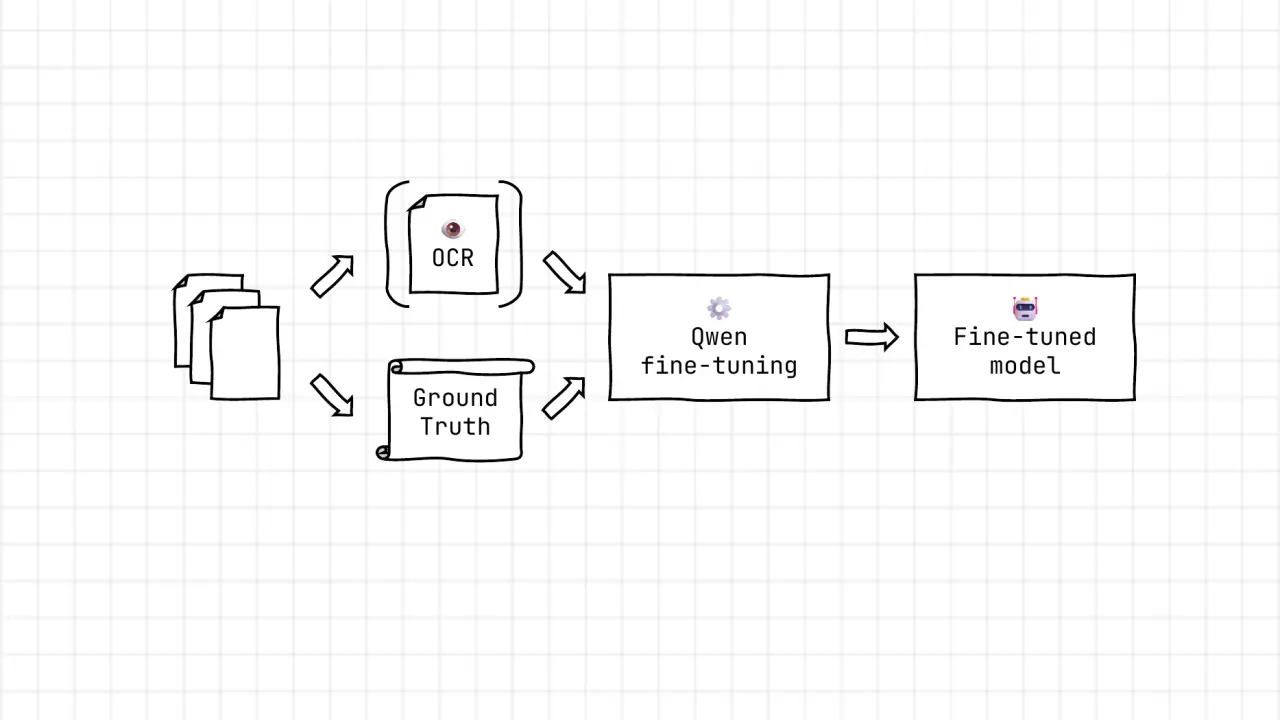
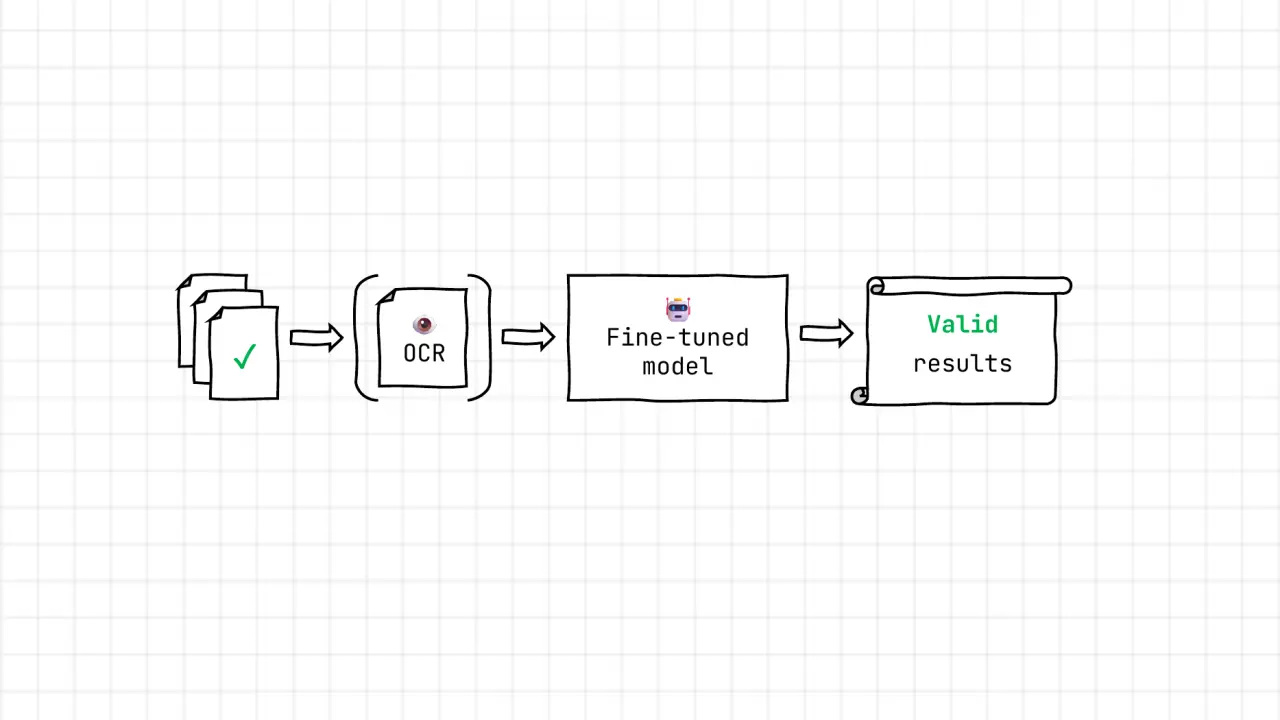
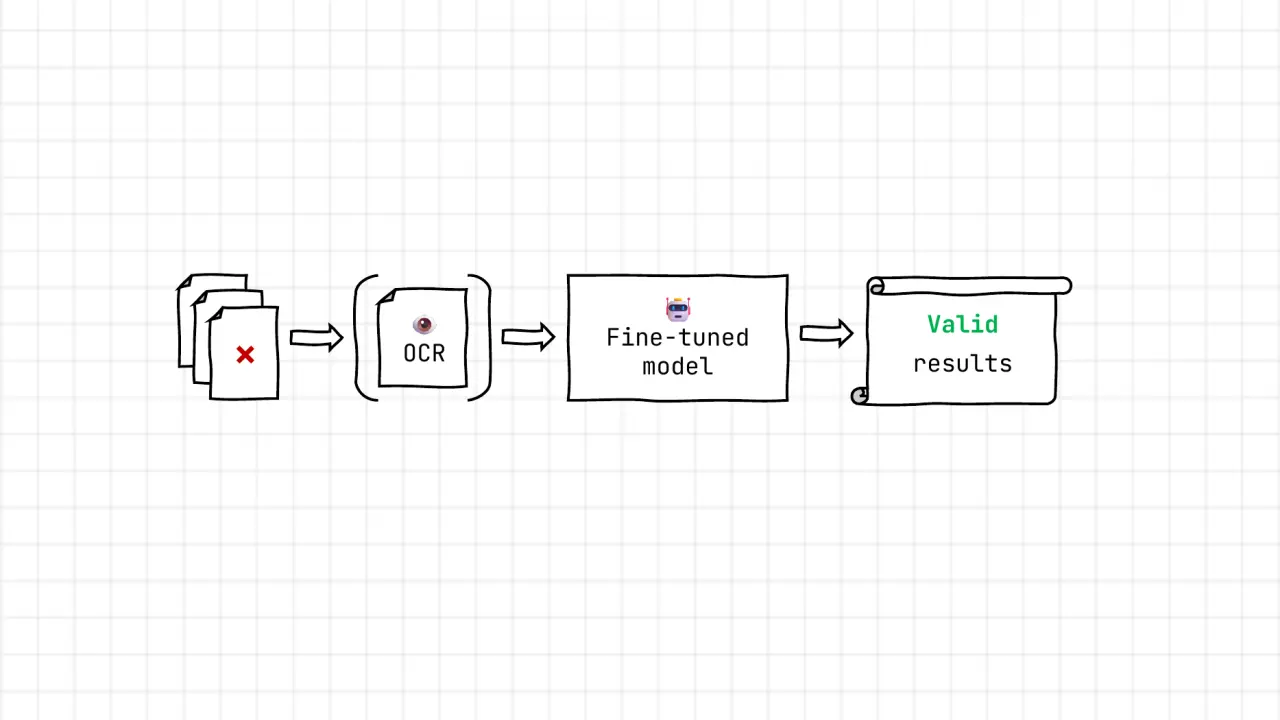
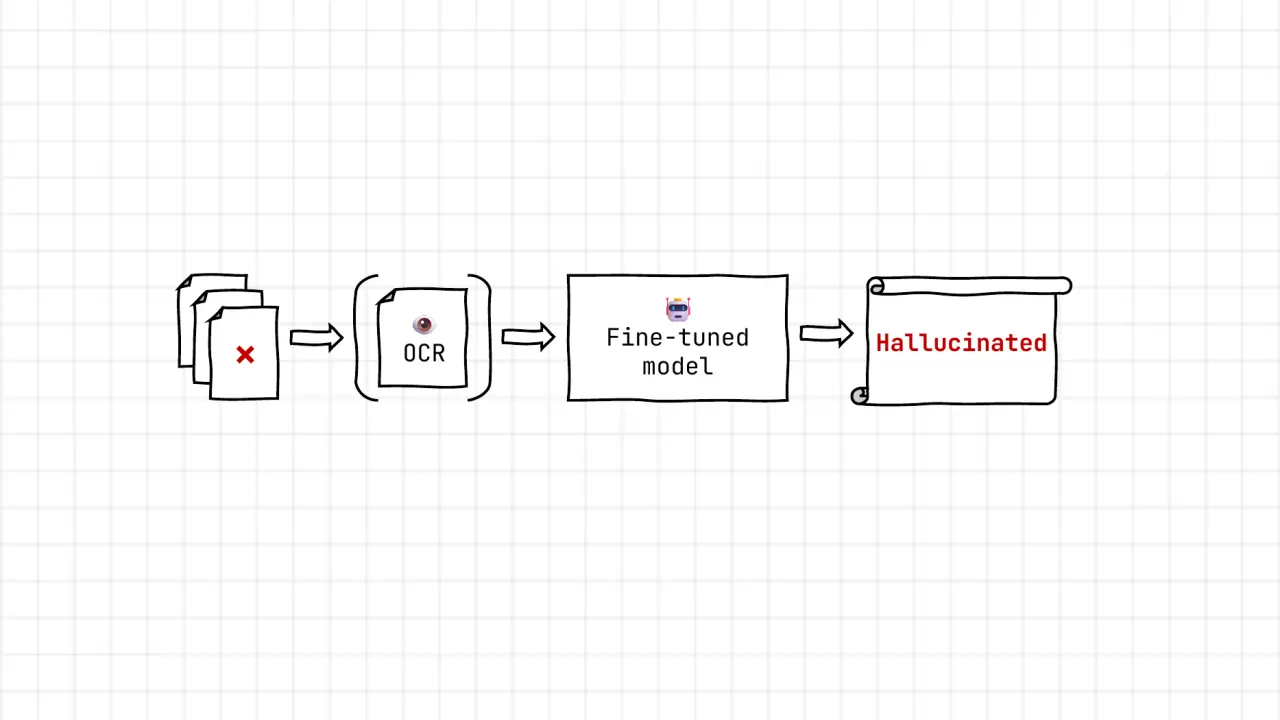
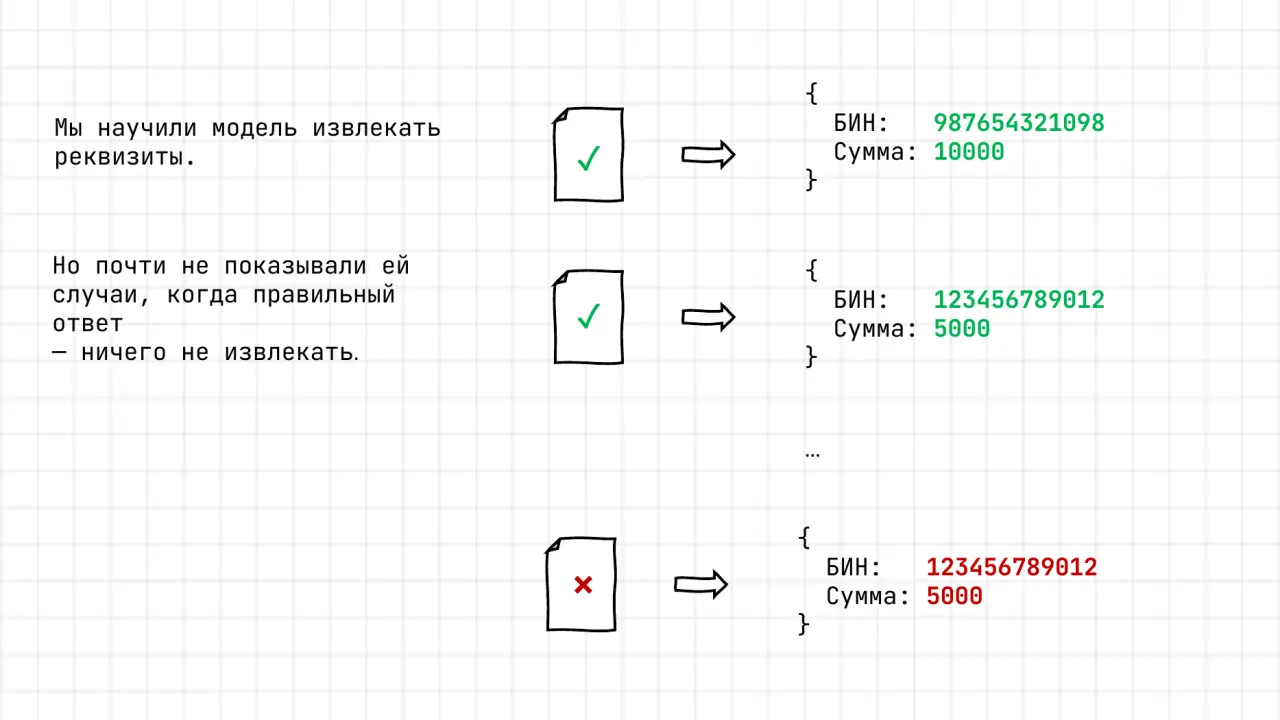
Александр Канцеляристов показывает проблему на двух практических кейсах: Whisper генерирует текст на тишине и шуме, а fine-tuned Qwen2.5 7B извлекает несуществующие реквизиты из пустых или неизвестных платёжных документов. Temperature=0 делает такие галлюцинации воспроизводимыми, но не устраняет их.
В докладе: — почему высокая точность на валидных данных ничего не говорит о неизвестных входах — как использовать negative и OOD evaluation, abstention и отдельную проверку применимости модели — как ошибка становится бизнес-проблемой, когда downstream-система принимает вероятностный вывод за факт — чему учат кейсы Deloitte, Air Canada и медицинских транскрипций Whisper — как validation, авторитетные источники, независимые модели и выборочная ручная проверка снижают риск
Видео
Презентация
 1 / 23
Текст презентации
Слайд 1: Когда ИИ уверенно
Когда ИИ уверенно ошибается Канцеляристов Александр Senior ML/AI Engineer, Bereke Bank галлюцинации моделей и риски для бизнеса
Слайд 2: Здравствуйте! это <неразборчиво>
- Здравствуйте! это <неразборчиво> - Здравствуйте! Не расслышал имя - <неразборчиво> - Ещё раз? - Субтитры подготовил Дима Торожок
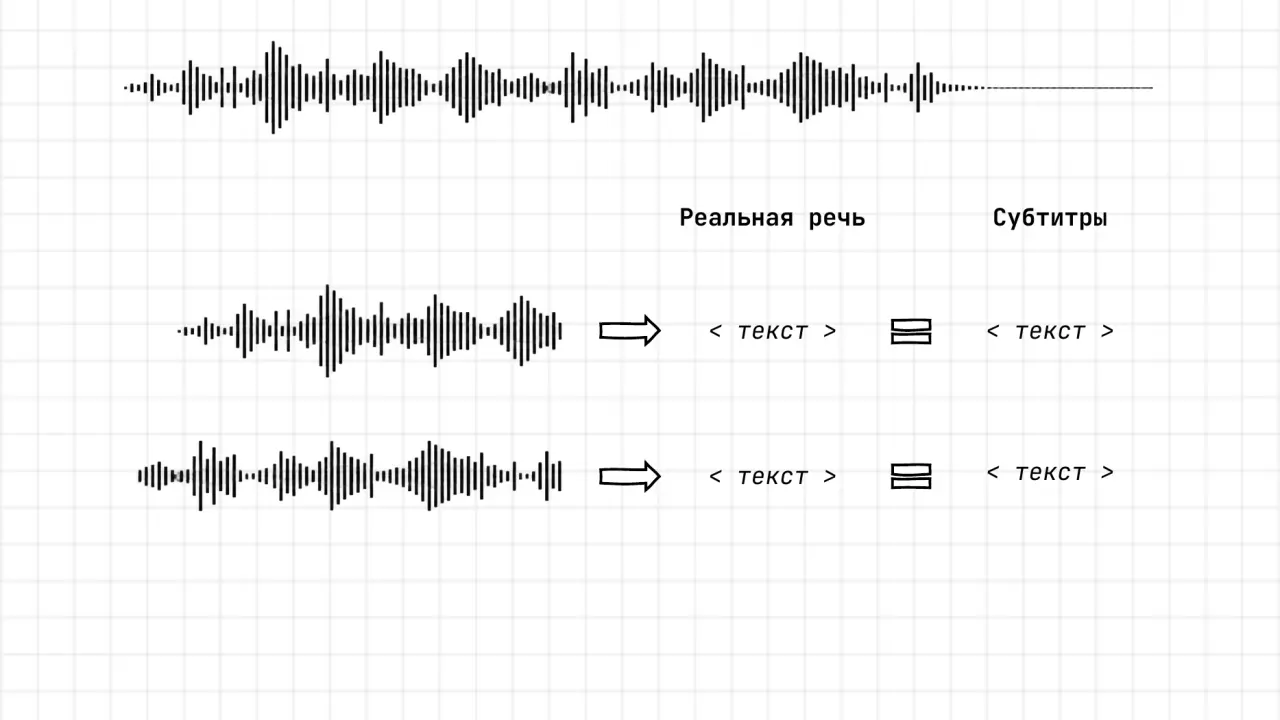
Слайд 4: Реальная речь Субтитры
Реальная речь Субтитры < текст > < текст > < текст > < текст >
Слайд 5: Реальная речь Субтитры
Реальная речь Субтитры < текст > < текст > < текст > < текст > null < текст >
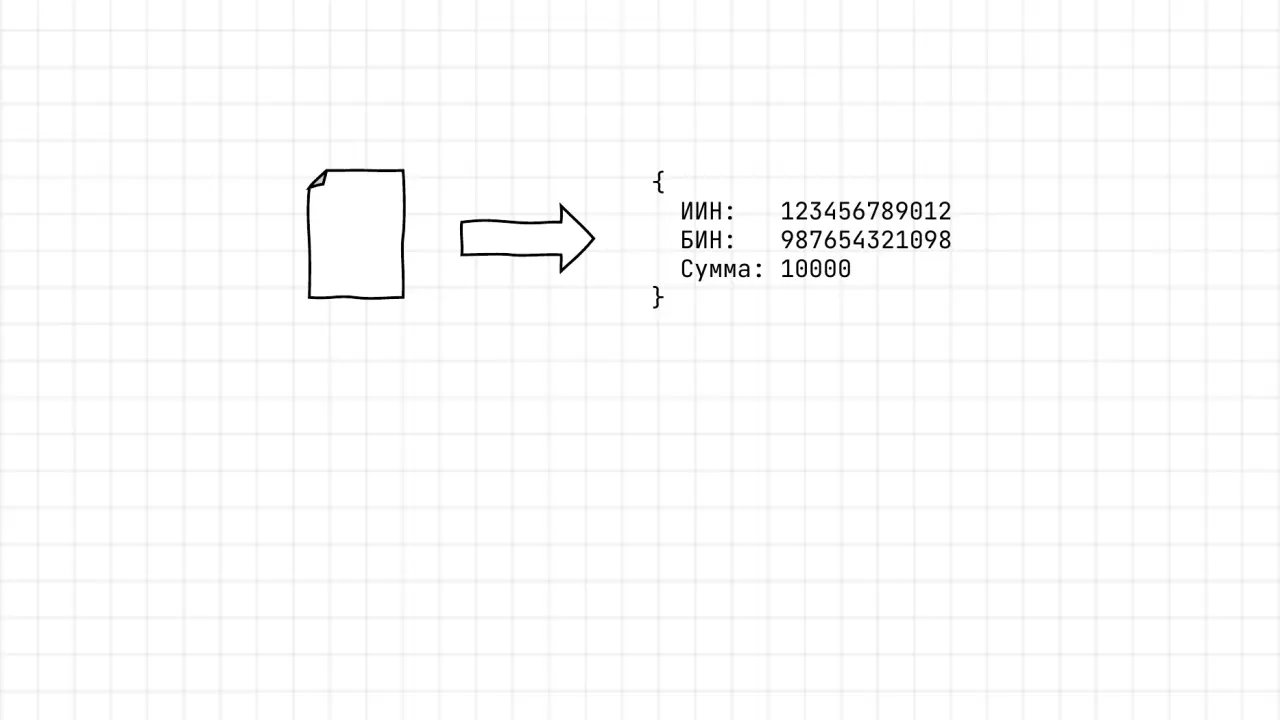
Слайд 7: ИИН: 123456789012
ИИН: 123456789012 БИН: 987654321098 Сумма: 10000
Слайд 8: Qwen
Qwen fine-tuning Fine-tuned model Ground Truth OCR
Слайд 9: Fine-tuned
Fine-tuned model OCR Valid results
Слайд 10: Fine-tuned
Fine-tuned model OCR Valid results
Слайд 11: Fine-tuned
Fine-tuned model OCR Hallucinated
Слайд 12: БИН: 987654321098
БИН: 987654321098 Сумма: 10000 БИН: 123456789012 Сумма: 5000 БИН: 123456789012 Сумма: 5000 Мы научили модель извлекать реквизиты. Но почти не показывали ей случаи, когда правильный ответ — ничего не извлекать.
Слайд 13: Fine-tuned
Fine-tuned model OCR Hallucinated Temperature Упрощённый пример: варианты продолжения после «БИН:» null 0.13 чебурек 0.01 temperature = 0 - выбирается наиболее вероятное продолжение Как работает генеративная модель? При генерации модель оценивает вероятности возможных следующих токенов. Выбранный токен добавляется к ответу, после чего процесс повторяется.
Слайд 14: Fine-tuned
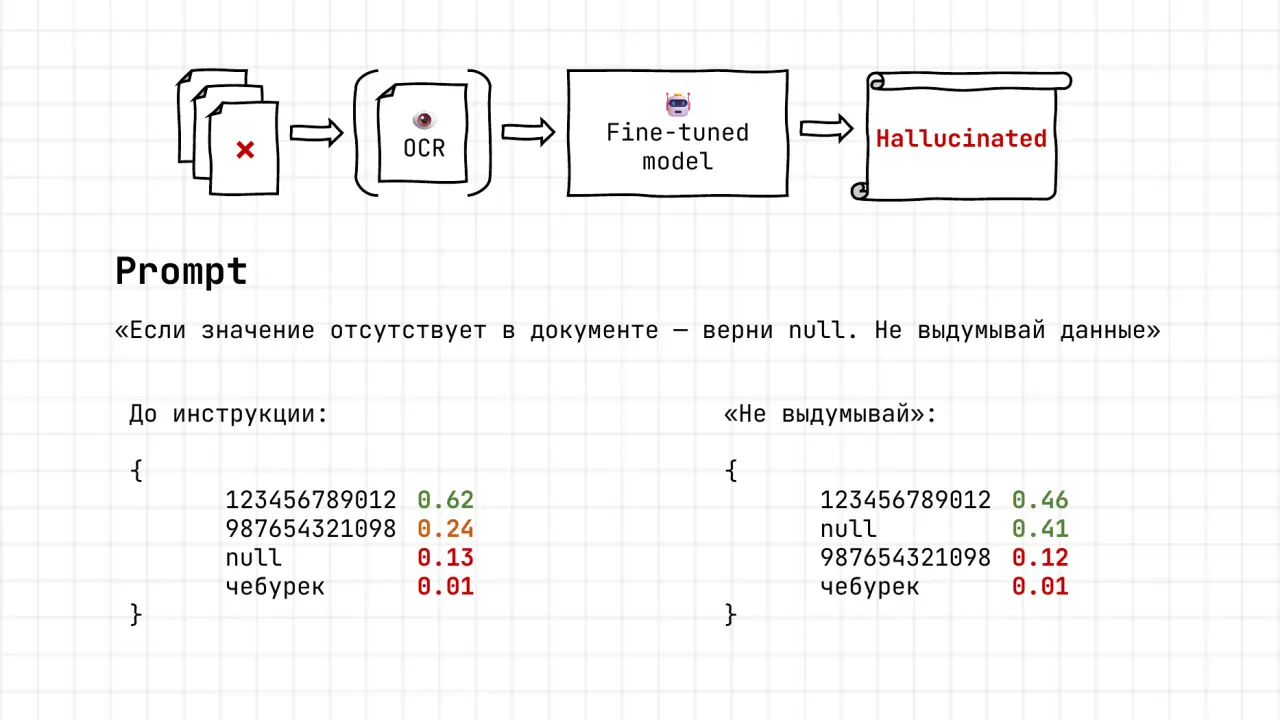
Fine-tuned model OCR Hallucinated Prompt До инструкции: null 0.13 чебурек 0.01 «Если значение отсутствует в документе — верни null. Не выдумывай данные» «Не выдумывай»: null 0.41 чебурек 0.01
Слайд 15: Qwen
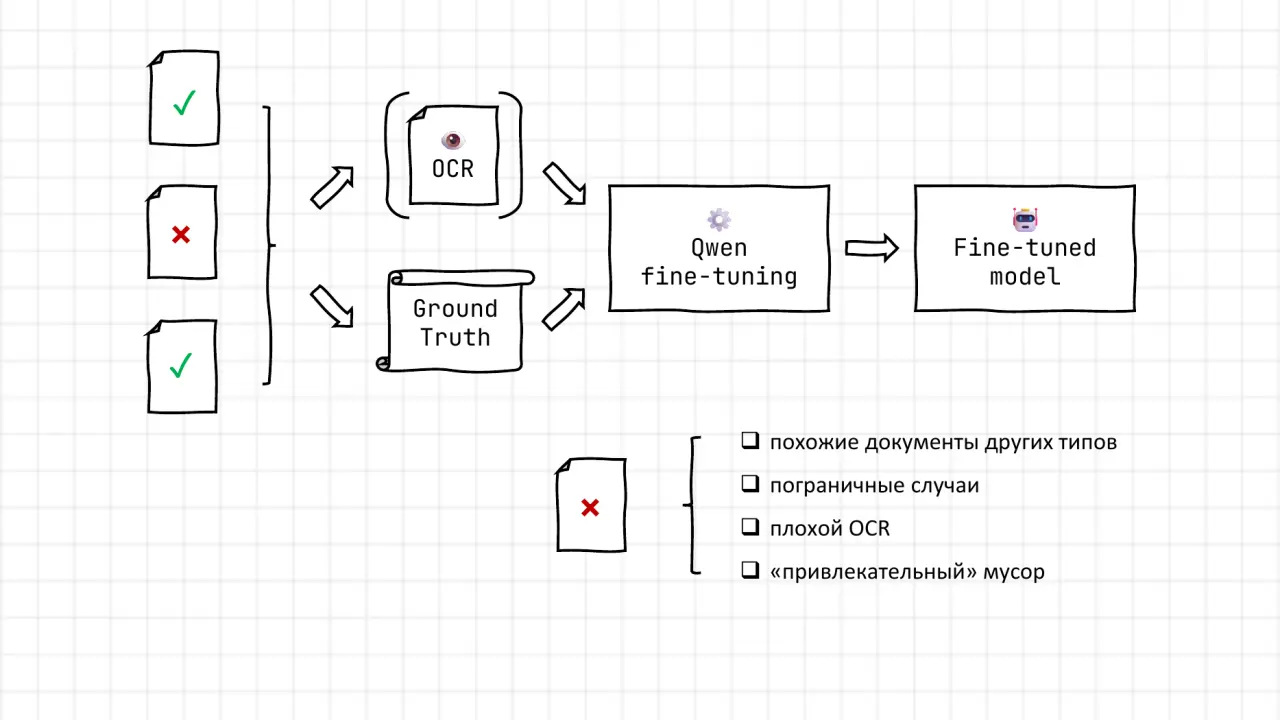
Qwen fine-tuning Fine-tuned model Ground Truth OCR ❑ похожие документы других типов ❑ пограничные случаи ❑ плохой OCR ❑ «привлекательный» мусор
Слайд 17: Что произошло
Что произошло В отчёте для правительства Австралии обнаружили несуществующие источники и выдуманную цитату из судебного решения. В исправленной версии отчёта Deloitte раскрыла использование инструментария на базе Azure OpenAI. Последствия Контракт — около A$440 тыс. Deloitte пришлось исправить отчёт и частично вернуть оплату.
Слайд 18: Что произошло
Что произошло Чатбот сообщил пассажиру, что льготный тариф можно оформить задним числом после поездки. Политика компании этого не предусматривала. Последствия Air Canada признали ответственной за информацию чатбота и обязали выплатить убытки. Но главный ущерб тут не сумма, а доверие к официальному чатботу компании.
Слайд 19: Что произошло
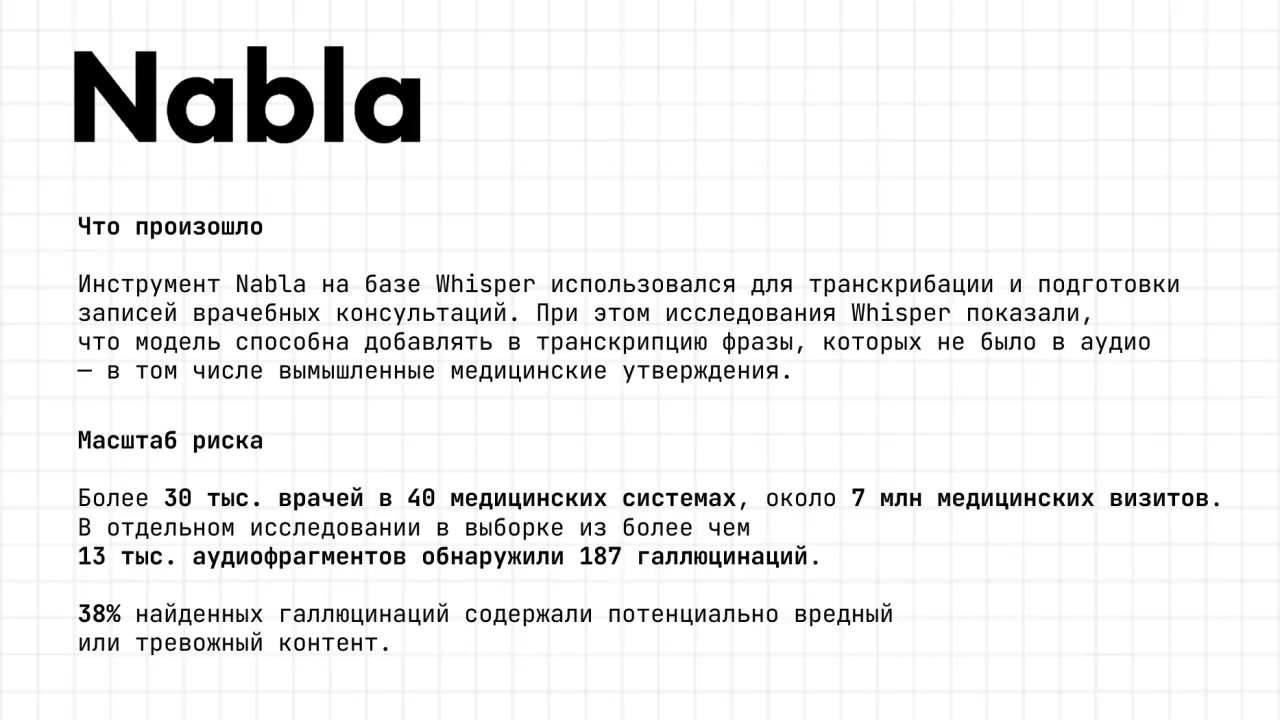
Что произошло Инструмент Nabla на базе Whisper использовался для транскрибации и подготовки записей врачебных консультаций. При этом исследования Whisper показали, что модель способна добавлять в транскрипцию фразы, которых не было в аудио — в том числе вымышленные медицинские утверждения. Масштаб риска Более 30 тыс. врачей в 40 медицинских системах, около 7 млн медицинских визитов. В отдельном исследовании в выборке из более чем 13 тыс. аудиофрагментов обнаружили 187 галлюцинаций. 38% найденных галлюцинаций содержали потенциально вредный или тревожный контент.
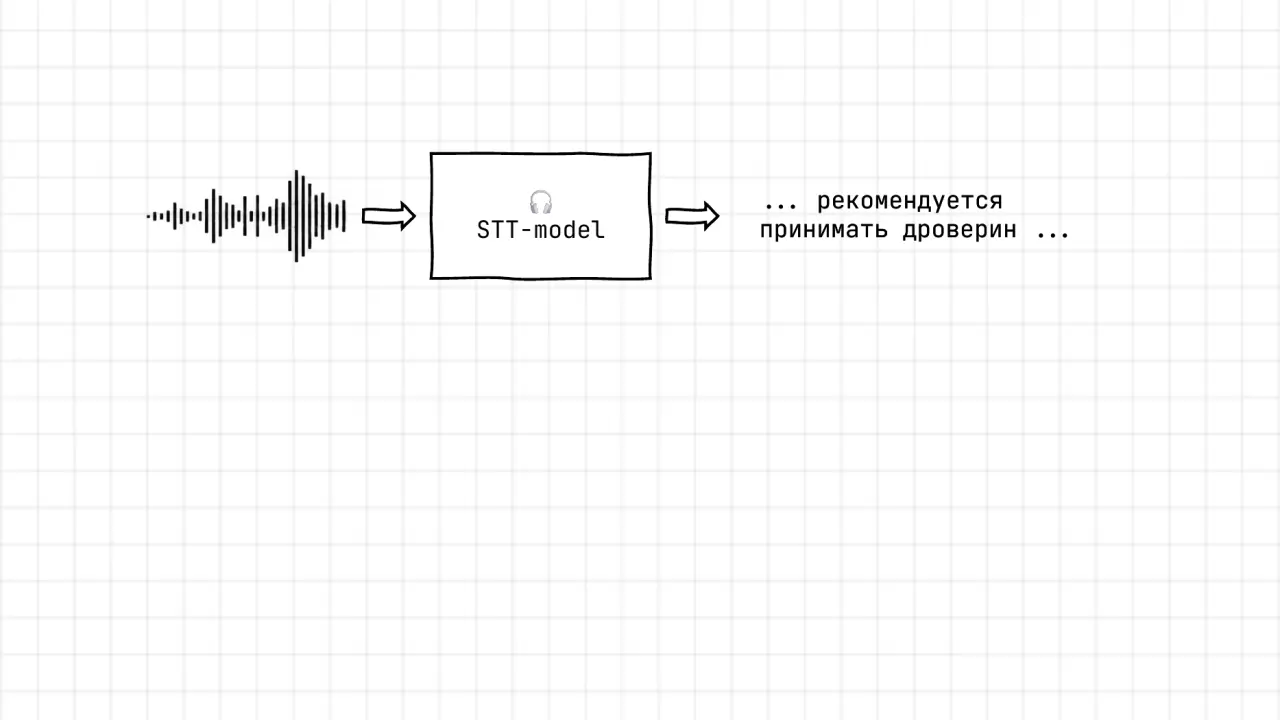
Слайд 20: STT-model
STT-model ... рекомендуется принимать дроверин ... STT-model ... рекомендуется принимать дроверин ...
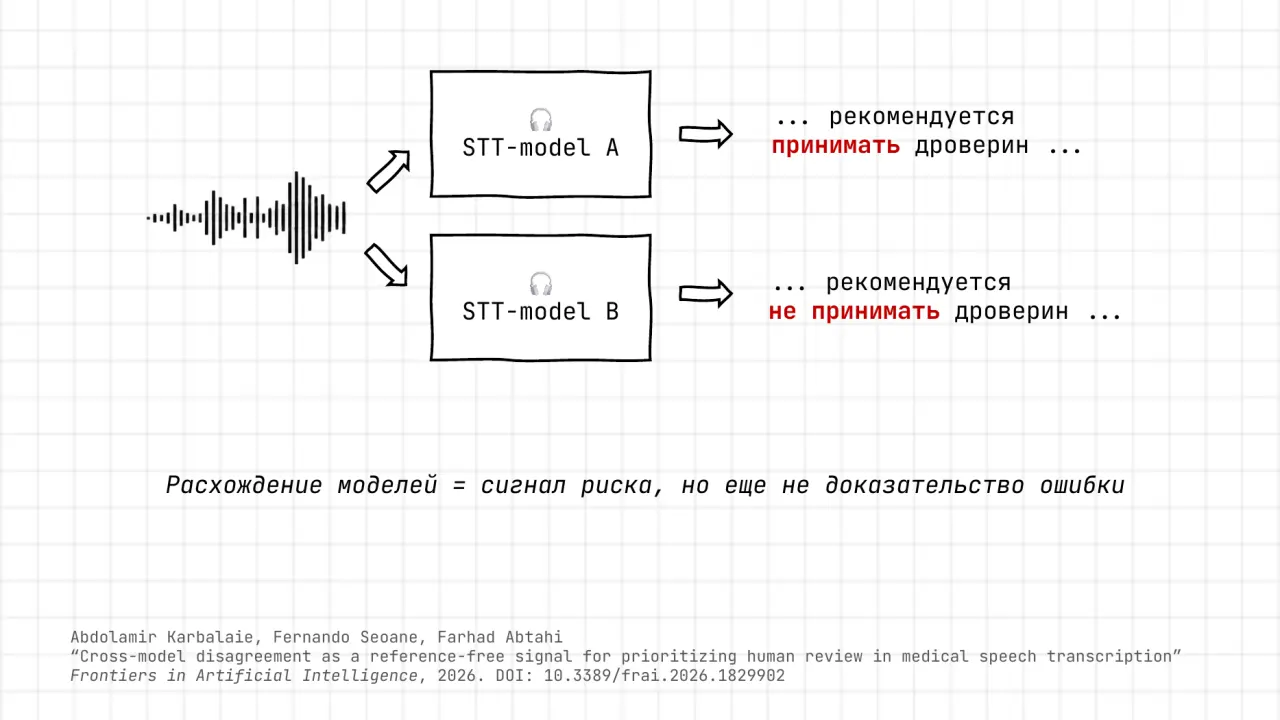
Слайд 21: STT-model B
STT-model B ... рекомендуется принимать дроверин ... STT-model A ... рекомендуется не принимать дроверин ... Расхождение моделей = сигнал риска, но еще не доказательство ошибки Abdolamir Karbalaie, Fernando Seoane, Farhad Abtahi “Cross-model disagreement as a reference-free signal for prioritizing human review in medical speech transcription” Frontiers in Artificial Intelligence, 2026. DOI: 10.3389/frai.2026.1829902
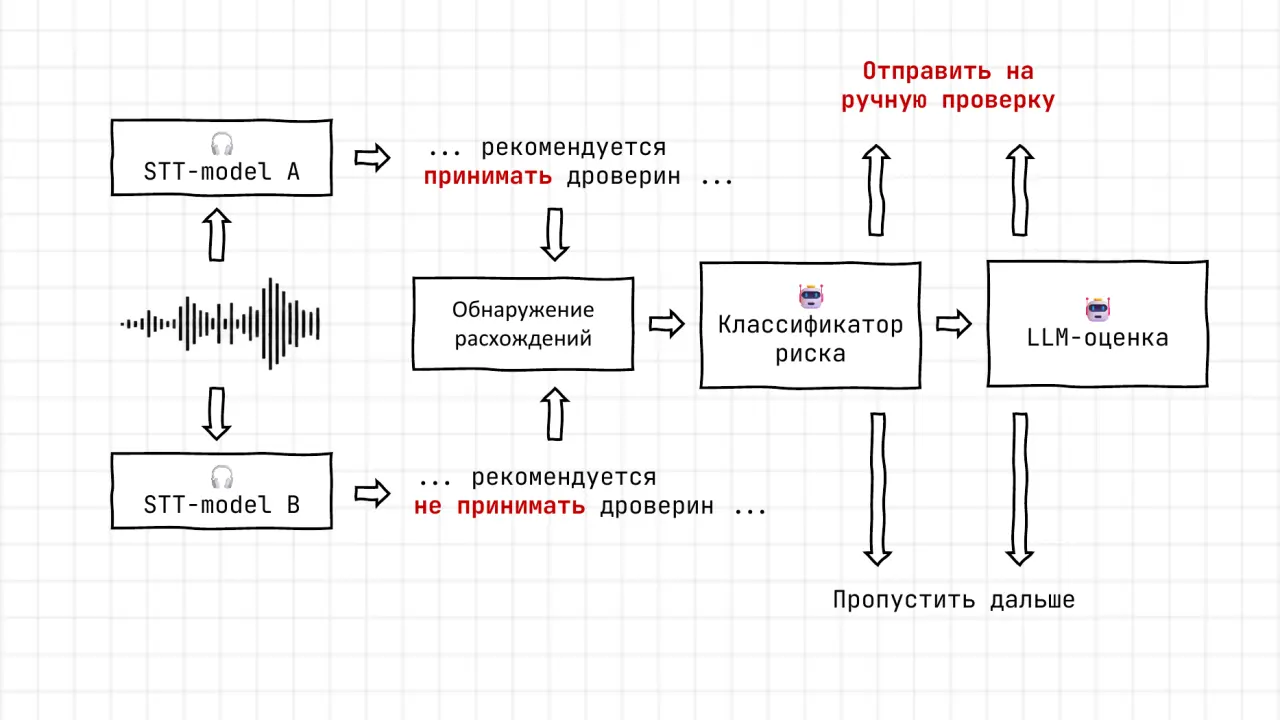
Слайд 22: STT-model B
STT-model B ... рекомендуется принимать дроверин ... STT-model A ... рекомендуется не принимать дроверин ... Обнаружение расхождений Классификатор риска LLM-оценка Отправить на ручную проверку Пропустить дальше
Слайд 23: ИИ может допускать ошибки.
ИИ может допускать ошибки. Рекомендуем проверять важную информацию.
Другие доклады митапа
 Платформа данных для AI-агентов с RAG Диана Аимбетова
 Agentic SDLC: от постановки задачи до продакшена с AI-агентами Азамат Галимжанов
 Обновление Python в 30+ ML-сервисах: uv, Ruff и ty Денис Крумко
 Мой код говорит сам за себя: как заставить его говорить и не запинаться Болат Тишкамбеков